Posts by Stefan Wintermeyer · 256 posts

Neu auf vutuv: Nachweise für Zertifikate & Lizenzen
Ihr könnt jetzt zu jedem Zertifikat und jeder Lizenz einen Nachweis hochladen, als PDF oder als Bild (bis 10 MB). Auf dem Profil erscheint dazu eine kleine Vorschau. Wer sie anklickt, kann das Original ansehen und herunterladen.
Veröffentlicht wird nichts ohne eure ausdrückliche Zustimmung. Beim Hochladen gibt es ein Kästchen, das genau erklärt: Die Datei ist danach öffentlich sichtbar und kann von jedem heruntergeladen werden. Ohne Häkchen wird nichts gespeichert. Ladet bitte nur Dokumente hoch, die ihr veröffentlichen dürft, und schwärzt sensible Angaben wie Adressen oder Ausweisnummern vorher. Direkt nach dem Upload prüft unsere automatische Bildprüfung die Datei kurz, so lange seht nur ihr sie.
Ausprobieren könnt ihr das hier: vutuv.de/settings/qualifications
Das Feature ist ganz frisch. Testet es bitte. Fehler bitte als Issue auf GitHub melden.
Die Bücher von Wladimir Kaminer sind ja schon sehr unterschiedlich in der Qualität. Das hier ist ein gutes. Lauter kleine Geschichten. Grob mit der Klammer “Schönhauser Allee” umschlossen. Schon die erste Geschichte vom Ehemann, der seine Frau mit einem überfahrenen Wildschwein beschenken möchte und dann aber vom SEK überrascht wird ist richtig kurzweilig und lustig. Wenn man Kaminer mag, dann macht man mit diesem Buch nichts falsch.

190 pages
Schönhauser Allee
by: Wladimir Kaminer2001 · Audiobook (approx. 1 h 15 min) Publisher: Goldmann
ISBN 978-3-442-54168-3

Eine Bitte an alle Fediverse Spezialisten: Könnt Ihr einmal die offenen Issues unter github.com/wintermeyer/vutuv/… durchgehen und mit 👍 abstimmen, was wichtig ist? Das hilft bei der Priorisierung.
Gerade mit @johannes_haseneder ein sehr interessantes Gespräch zu vutuv und LinkedIn geführt. Er hat ein phantastisches Bild zu LinkedIn gezeichnet: Es ist wie früher in der Disco. Viel zu viel los. Laut. Ungemütlich. Teure und schlechte Getränke. Aber man geht trotzdem hin, weil man die Hoffnung hat jemand interessanten zu treffen.
Gestern wurde im heute journal (Video an Position 15:42) über die NSDAP-Karteikarten Suchfunktion auf sueddeutsche.de und anderen Zeitungen berichtet. Etwas spät (das Projekt gibt es ja schon seit Monaten), aber das nur am Rande. Als heise.de im März 2026 über die Möglichkeit der Suche im US-Nationalarchiv berichtete, hatte ich schon mal einen Blick reingeworfen (die Suche bei der Süddeutschen ist übrigens deutlich einfacher, aber leider mit einer Paywall). Mein Großvater väterlicherseits ist in der Datenbank aufgelistet. Ich kannte ihn nicht. Er ist weniger Monate vor meiner Geburt gestorben. Die Information an sich war nicht neu für mich. Mein Vater hat nie ein Geheimnis daraus gemacht, das sein Vater ein offener Anhänger der NSDAP war.
PS: Mütterlicherseits sieht es übrigens komplett anders aus. Mein Ur-Großvater war ein politisch verfolgter und laut Aussage meiner Oma im KZ (dafür gibt es leider keine öffentliche Datenbank). Das KZ hat er überlebt und wurde danach wohl von den Russen (Besatzungszone) ins Gefängnis eingesperrt (wieder als politischer Gefangener). Als er dann frei kam ist er mit seiner Familie in den Westen geflüchtet.

Ein kurzer Blick in den vutuv Maschinenraum: Hier seht ihr, wie ich mit Claude vier verschiedene Issues parallel abarbeite. Natürlich übernimmt der Agent nicht das Denken komplett. Ich gehe die Liste der offenen Issues durch und wähle diejenigen aus, die ich bearbeiten möchte und die parallel laufen können, ohne sich beim Programmieren gegenseitig zu stören. Dann starte ich claude —worktree issue888 und gebe Claude die notwendigen Hintergrundinformationen zu dem Issue.
Bei gut formulierten Issues sage ich Claude: Fix it. Create a PR and merge it. Add a thank you note. Bei einigen Issues beginne ich jedoch mit einem Dialog mit Claude. Ich frage zum Beispiel nach den Auswirkungen des Features auf den Code oder nach sinnvollen Alternativen. Oft starte ich auch /rc und gehe dann mit dem Hund spazieren oder zum Supermarkt. Claude meldet sich dann per Handy, wenn er eine Frage hat.
Je nach Issue füge ich noch Anweisungen wie Run a browser smoke test. oder Details zur thank you note hinzu.
Die zugrunde liegenden CLAUDE.md Regeln optimiere ich ständig und diskutiere den ganzen Workflow mit anderen Entwicklern. Shoot out an @oliverandrich der mir viel Input und Ideen gibt.
Ich habe übrigens auch eine Regel, die Claude auffordert nach einer Problemlösung selbstständig eine bessere CLAUDE.md Regel vorzuschlagen. Wichtig ist ebenfalls hin und wieder alles aufzuräumen. Die Menge der CLAUDE.md Regeln darf nicht ausufern.

Caveman: Claude Code redet wie Höhlenmensch
Im ohnehin dichten Strom neuer Claude-Code-Skills sticht ein Repository ungewöhnlich weit heraus. Caveman von Julius Brussee sammelt seit Anfang April 2026 über 90.000 GitHub-Sterne ein. Die Prämisse ist so simpel wie kurios: Der Skill weist Claude Code an, in einer rudimentären, an Höhlenmenschen erinnernden Kurzform des Englischen zu antworten. Ein Alltagsbeispiel zeigt das Prinzip. Vorher: „It is going to rain later this afternoon, so you might want to take an umbrella with you“. Nachher: „Rain later. Take umbrella“. Das Motto aus dem README bringt die Idee auf den Punkt: „why use many token when few do trick“.
Was der Skill tut
Caveman bündelt Slash-Commands, einen MCP-Wrapper (Middleware zwischen Claude und externen Werkzeugen) und ein Skript zur Verdichtung der Memory-Dateien. Aktiviert wird der Modus per /caveman oder Klartext-Anweisung „talk like caveman“. Drei Stufen sind in der Praxis relevant: lite (leichte Kürzung), full (Default) und ultra (radikal). Brussee verspricht 65 bis 75 Prozent Token-Ersparnis. Daneben kondensiert /caveman-commit Commit-Botschaften, /caveman-review schrumpft PR-Kommentare auf eine Zeile, und /caveman-compress verdichtet Markdown-Memorys laut README um 46 Prozent.
Die Installation läuft in 30 Sekunden per curl-Einzeiler (macOS, Linux, WSL) oder PowerShell-irm (Windows). Voraussetzung: Node.js ab Version 18, Lizenz MIT. Neben Claude Code unterstützt der Skill rund 30 weitere Coding-Agenten, darunter Codex, Cursor und Copilot.
Was den Reiz ausmacht
Zwei Gründe sprechen für Caveman. Erstens die Token-Ökonomie. Wer Claude häufig nutzt, kennt die anschwellenden Token-Zähler. Ein um zwei Drittel kürzerer Output schlägt sich unmittelbar in der Abrechnung nieder und füllt das Kontextfenster langsamer, weil er als Verlauf in jeden weiteren Turn einfließt. Die Statistik /caveman-stats weist das eingesparte Volumen sogar in US-Dollar aus.
Zweitens die Geschwindigkeit, gleich in zweifacher Hinsicht: Eine Zeile wie „Off-by-one in pagination loop. Uses < not <=“ erfasst sich schneller als der ausformulierte Stand der Lehre, den erfahrene Entwickler längst kennen. Und weil LLMs Tokens sequenziell erzeugen, sinkt mit kürzerem Output auch die Antwortzeit. Bei langen Erklärungen spürbar, bei knappen Antworten weniger.
Wo der Charme bröckelt
So weit die Werbeprosa. In der Realität stößt das Konzept rasch an Grenzen, die das Repository selbst nicht thematisiert.
Die wichtigste betrifft die Sprache. Sämtliche Regeln im Skill-Prompt sind auf Englisch zugeschnitten. Der Skill weist Claude an, die Artikel a, an und the zu streichen, listet englische Füllwörter wie „just“, „really“, „basically“, „actually“ und „simply“ sowie englische Höflichkeitsfloskeln wie „sure“, „certainly“ oder „happy to“. Die mitgelieferten Beispiele zeigen ausschließlich englische Ausgaben. In der Praxis funktioniert der Modus deshalb nur auf Englisch gut.
Die zweite Grenze ist die Nuance. Komprimierung ist immer Verlust. Aus „This pattern is acceptable because the component owns its state, but in a shared-state context it would cause re-renders“ wird in full schnell „state local, fine. shared, bad“. Die Aussage stimmt im Kern, die für eine Architekturentscheidung relevante Bedingung verschwindet jedoch. Erfahrene Entwickler kompensieren das mit Nachfragen, die allerdings jede Token-Ersparnis ad absurdum führen, weil jede Klärung selbst wieder Tokens kostet. Einsteiger nehmen die verkürzte Heuristik unter Umständen als Regel. Genau hier liegt die Crux: Der Modus spart Token in jenen Antworten, in denen die Nuancen am ehesten zählen.
Zwei Erkenntnisse aus der KI-Forschung erweitern diese Skepsis. Sprachmodelle sind auf vollständige Prosa trainiert; reguläre Antworten liegen näher an dieser Trainingsverteilung und fallen schon deshalb substanzieller aus. Eine ACL-2024-Studie (Jin et al.) zeigt zudem: Verkürzte Reasoning-Schritte mindern die Leistung selbst bei erhaltener Information. Caveman beschneidet damit jenen „Denkraum“, den das Modell sonst über seine Ausgabe-Tokens entfaltet.
Hype-Kurve und stille Indizien
Die Sterne-Kurve stützt eine vorsichtige Lesart. Nach dem viralen Initialschub flacht das tägliche Wachstum sichtbar ab. Auch die offenen Issues häufen sich schneller, als Commits sie abarbeiten. Eindeutig zu lesen ist das nicht: Es kann ein Warnsignal sein, ebenso gut aber Folge einer Zeit, in der KI-Assistenten Issues und Pull Requests in einem Tempo einreichen, das ein einzelner Maintainer kaum noch sortieren kann.
Das wichtigste Indiz: Wäre das Konzept ein echtes Produktivitätswerkzeug, hätte Anthropic selbst längst eine vergleichbare Funktion in Claude Code eingebaut oder das Projekt übernommen. Bislang ist davon nichts zu sehen. Auch in Teams, die den Skill in Coding-Sessions testen, bleibt nach informellen Berichten nur ein Bruchteil dauerhaft beim Caveman-Modus.
Was sich mitnehmen lässt
Den Kern der Idee gibt es auch ohne Plugin. Eine kurze Anweisung in der projektweiten CLAUDE.md oder der globalen ~/.claude/CLAUDE.md reicht:
- Fasse dich kurz. Verzichte auf Höflichkeitsfloskeln, einleitende
  Bestätigungen und Wiederholungen der Frage.
- Antworte direkt mit dem technischen Kern, gerne in Stichpunkten.
- Code-Blöcke, Fehlermeldungen und Bezeichner bleiben unverändert.
Das funktioniert sprachneutral und lässt vollständige Sätze zu, wo Nuancen tragen. Hooks und MCP-Wrapper bleiben außen vor, der Lerngewinn nicht.
Fazit
Caveman ist ein gelungener Hack und ein Beleg dafür, wie schnell ein Meme heute GitHub-Trends dominiert. Als gelegentliches Experiment für Routinesitzungen lässt sich der Modus rechtfertigen. Als Default-Setting für seriöses Pair-Programming taugt er nicht. Wer Token sparen will, fährt mit dieser CLAUDE.md-Regel besser. Antworten zu kürzen bleibt eine gute Idee. Der Höhlenmensch-Sprech muss es dafür nicht sein.
Pro und Contra
| + | – |
|---|---|
| 65 bis 75 % weniger Output-Token, sichtbar in Rechnung und Kontextfenster | Regeln und Beispiele rein englisch, deutscher Einsatz kaum praktikabel |
| Schnellere Antworten bei langen Erklärungen | Nuancenverlust gerade bei Architekturfragen |
| Verkürztes Reasoning kann laut ACL-2024-Studie die Modellleistung mindern |
Ab sofort lassen sich Bilder inline im Markdown Text platzieren. Vorher waren sie immer automatisch in einer Galerie am Ende des Textes. Das soll dem Autor ermöglichen Posts besser zu gestalten und für den Leser sinnvoller/angenehmer machen.
 Bei der GUI bin ich mir noch nicht 100%ig sicher, was der beste Weg ist und freue mich über Anregungen dazu. Aktuell kann man per u.a. Bilder einfach per Drag and Drop in den Editor ziehen und dann rechts, links oder zentriert positionieren.
Als Beispielfoto seht Ihr hier ein Frühstück im EM Breakfast Club Hamburg. Sehr zu empfehlen!
PS: In der mobilen Ansicht werden Bilder nicht rechts und links, sondern nur direkt im Text angezeigt.

Bin gerade über chatto.run von @hendrik_mans gestolpert. “Chatto is a fast, fully-featured chat app”. Sehr cooles neues Open-Source-Projekt.

Im Englischen gibt es die Begriffe “family friendly” und “NSFW” (Not Safe For Work). Bilder die innerhalb der vutuv Plattform veröffentlicht werden, sollen immer “Safe For Work” und auch immer “family friendly” sein. Was genau in diese Rubriken fällt wird immer zu diskutieren sein. Für den einen ist eine Pistole OK und für den anderen nicht. Für den einen ist ein Bikini OK und für den anderen nicht. Das ist eine sich konstant bewegende Linie. Die Kulturen und Empfindungen sind da sehr unterschiedlich.
Ab heute ist eine automatische Moderation von neuen Bildern aktiviert. Das alles geschieht lokal auf unserer Hardware in Deutschland. Es werden keine Daten oder Bilder an externe Dienstleister gegeben. Wer sich für die Technik interessiert: Ich habe dazu in der iX 7/2026 einen Artikel veröffentlicht. heise.de/select/…
Das ist ein Feature, bei dem ich nachjustieren werde. Wenn irgendwo ein Foto vom Tool zu streng bewertet und damit automatisch gelöscht wird, dann erstellt dazu bitte ein GitHub Issue. Das gleiche gilt natürlich auch andersrum.
Letzte Nacht wurde in mein Auto eingebrochen. Sehr ärgerlich.
Etwas habe ich mich aber gefragt: Warum hat der Einbrecher die hintere kleine Scheibe kaputt geschlagen und nicht das größere Fenster in einer Tür? Die größeren Fenster müssten doch instabiler sein und entsprechend leichter kaputt gehen. Oder mache ich da einen Denkfehler?

Bugs und Feature Requests
Wichtig: Beides hilft dem Projekt sehr!
Die Prios sind aber anders. Ich schreibe das hier, um mehr Transparenz zu erzeugen. Bugs haben immer Vorrang! Egal wie groß, klein, wichtig oder unwichtig. Im Idealfall ist ein Bug innerhalb von 24 Stunden gefixt.
Feature Requests können schon mal liegen bleiben und es gibt keine Garantie, das sie überhaupt umgesetzt werden. Manchmal geht meine mentale Roadmap in eine andere Richtung und dann passt das gerade nicht. Kann aber durchaus sein, das das gleiche Feature Request ein Jahr später umgesetzt wird.
Am einfachsten ist es beides im GitHub einzutragen. Je kleiner und klarer ein Issue gefasst ist, desto schneller wird es gelöst. Issues mit mehreren Themen „versauern“ schon mal. Man kann hier auf ein neues Issue verweisen, aber es ist nicht notwendig.
Unter vutuv.de/settings/organizations kann man ab sofort Organisationen anlegen. Das können Firmen sein, aber auch Vereine, Schulen, NGOs, usw. Das ist ein erster Schritt. In einem nächsten wird man dann Punkte im Lebenslauf damit verknüpfen oder auch Stellenangebote dort veröffentlichen können. Alles Teil von github.com/wintermeyer/vutuv/…
Auf vutuv.de/settings/links kann man jetzt die eigenen Webseiten verifizieren. Entweder per Rück-Link REL=ME, DNS-TXT-Eintrag oder .well-known/vutuv-verify.txt Datei.
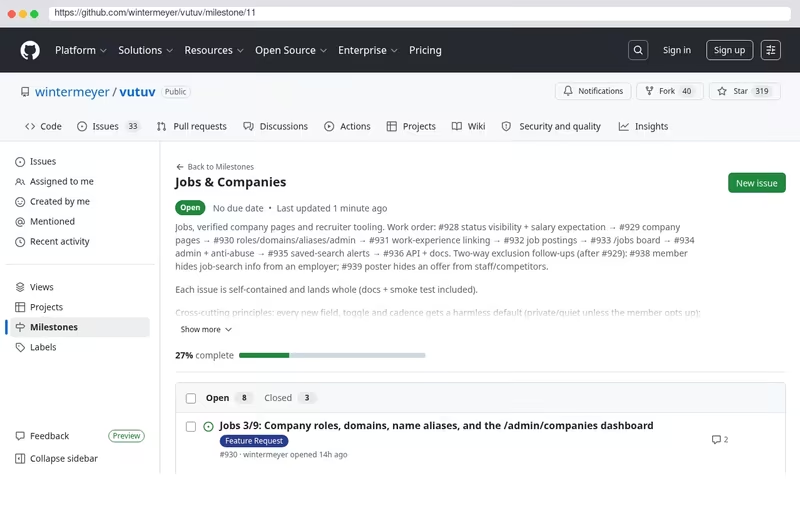
Die nächsten Tage kann es hier ein wenig Ruckeln. Ich arbeite an ein paar neuen Features zum Thema Stellenausschreibungen und Firmen. Nähere Infos hier: github.com/wintermeyer/vutuv/…
Also nicht direkt in Panik verfallen, falls mal irgendwo ein Menüpunkt nicht richtig ist oder irgendwas noch nicht 100% rund läuft. Wenn etwas auffällt, bitte ein Issue auf GitHub aufmachen. Das hilft mir am meisten.
In der aktuellen iX und auf heise+ ist ein Artikel von mir zur Thema Prompt-Caching. Damit lassen sich Tokens sparen und Geschwindigkeit gewinnen. heise.de/ratgeber/…

Auf vutuv.de/settings/preferences kann man ab sofort selbst konfigurieren, ab wie vielen Zeilen ein Post im Feed abgeschnitten wird. Und man kann auch konfigurieren, ob Silbentrennung durch den Browser automatisch erfolgen soll oder nicht. Nach Desktop und Mobile unterschieden.

Ab sofort werden bei Posts, die eine einzelne URL enthalten, Screenshots der entsprechenden Webseite automatisch erstellt und eingeblendet. Es ist ein Versuch. Mal schauen, wie viel Mehrwert es bringt. Shameless Plug Beispiel: wintermeyer-c


Kleines Update zum Editor und zum Thema Bilder im Post. Ich schreibe erst, warum das Thema komplex ist und dann was gestern passiert ist.
Aktuell dürfen Bilder unter einem Post upgeloadet und dann auch dort angezeigt werden. Also so wie auch bei allen anderen Social Networks. Da bei vutuv allerdings Markdown besser unterstützt wird und der Editor das prinzipiell auch kann, stellt sich schon die Frage, ob es nicht auch sehr schön/praktisch wäre im Post selber Bilder einbauen zu können. Ich möchte dieses Tor heute noch nicht öffnen. Ich will erst mal schauen, wie es mit der aktuellen Methode läuft. Bilder im Post können schnell das ganze Feed-Layout optisch ins Chaos stürzen. Ich gehe mit den aktuellen Markdown Möglichkeiten ja schon sehr weit. Bei LinkedIn und Co. hat man nicht die gleichen Möglichkeiten wie bei vutuv. ABER: Das ist keine endgültige Entscheidung!
Gestern hat der pfiffige - und das meine ich voll im Ernst - @oliver_lietz sich gedacht “Ist mir doch egal, ob der WYSIWYG Editor das kann. Ist ja schliesslich Markdown. Dann baue ich die Bilder halt selbst im Markdown ein.” (siehe ersten Screenshot vom Post). Das habe ich gestern Abend gesehen und mir gedacht “Hut ab!” 😉 Sah auch gar nicht wirklich schlecht aus. Aber ich wollte ja erst mal die Version ohne Bilder im Text ausprobieren. Deshalb habe ich danach eine Validierung eingebaut, die überprüft, das keine Bilder im Markdown enthalten sind und diese auch in einem Post nicht angezeigt werden. Siehe zweiten Screenshot vom gleichen Post danach.
PS: Natürlich greift die Validierung auch beim Zugriff über die API.


Es gibt einen neuen Editor in vutuv.
Posts und Nachrichten werden ja im Markdown-Format abgespeichert. Das ist für Techies praktisch, aber für alle normalen Menschen schon gewöhnungsbedürftig. Mit dem neuen Editor kann man jetzt halbwegs intuitiv Texte fett, kursiv und sonst was formatieren. Und wer will, kann weiterhin in Markdown schreiben.
Besonders gespannt bin ich auf den ersten Post mit einer Tabelle.

Interesting article about the beginning of Claude Code: anthropic.com/features/…
Es gibt ein neues Feature, um andere Personen zu vutuv einzuladen.Bitte probiert es einmal aus. Ich würde mich über Feedback dazu freuen. vutuv.de/system/invitations/…
Auf der eignen Profilseite kann man jetzt seinen Lebenslauf generieren und downloaden. Vielen Dank @lukas_schieren für diese tolle Idee und auch den anderen Feature-Request!
Mit dem .docx und .odt Layout bin ich noch nicht glücklich. Falls da jemand ein Händchen für hat würde ich mir über einen Pull-Request auf github.com/wintermeyer/vutuv freuen.