Berufsbildung
Tags 1 follower
Follow from the Fediverse
Follow #berufsbildung from Mastodon or any other Fediverse app and its public posts arrive in your timeline. No vutuv account needed.
@berufsbildung@tags.vutuv.de
Posts with this tag
3 posts
Filters

Im Rahmen meines selbstgesteuerten Lernens beschäftige ich mich derzeit auch mit Open Data und Datenvisualisierung. Dabei interessiert mich nicht nur die technische Umsetzung, sondern ebenso die Frage, wie sich öffentlich verfügbare Daten verständlich und nachvollziehbar aufbereiten lassen.
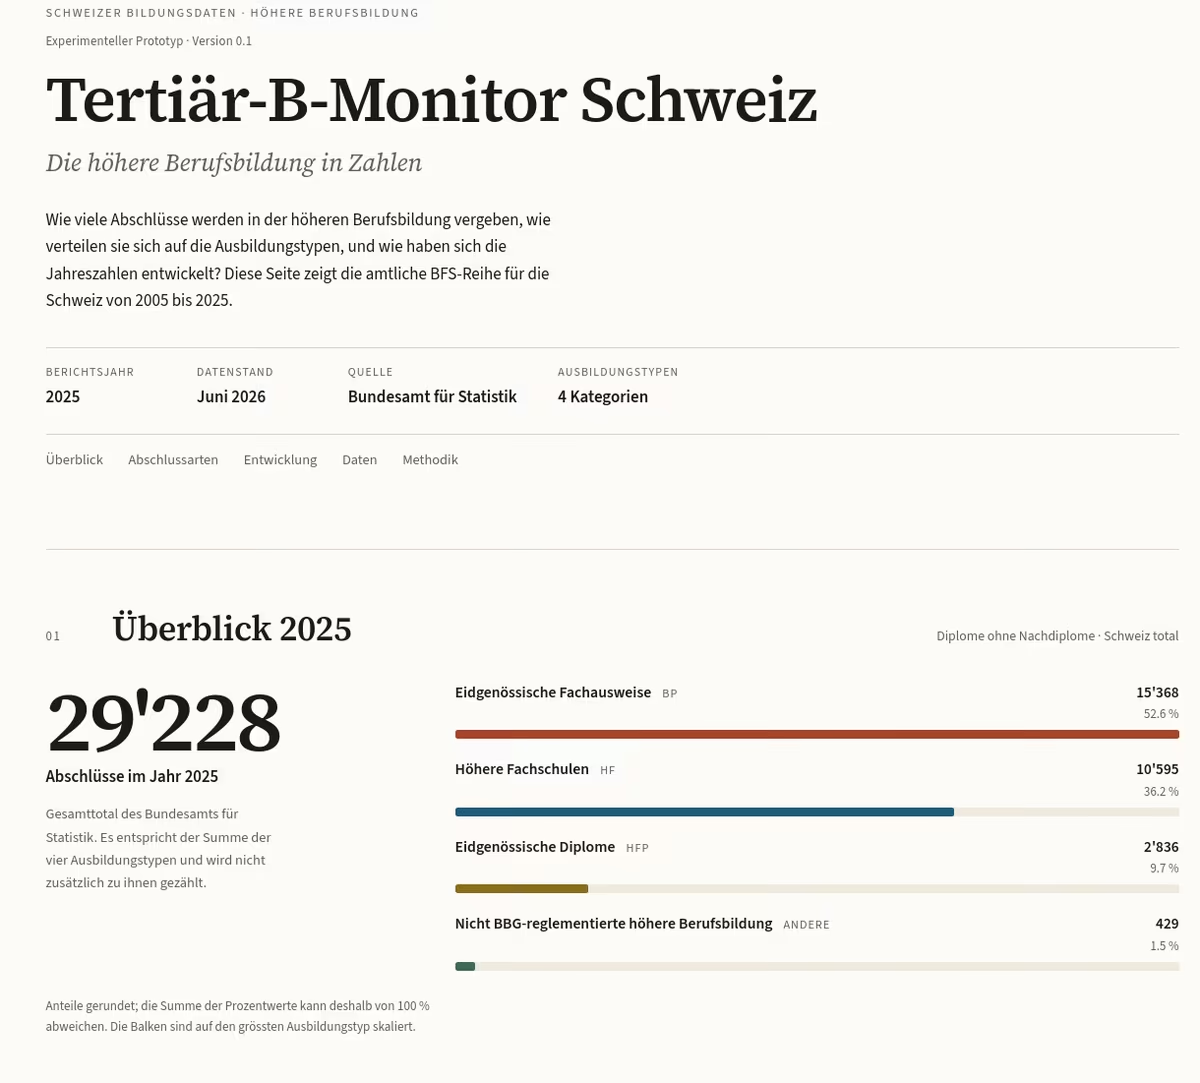
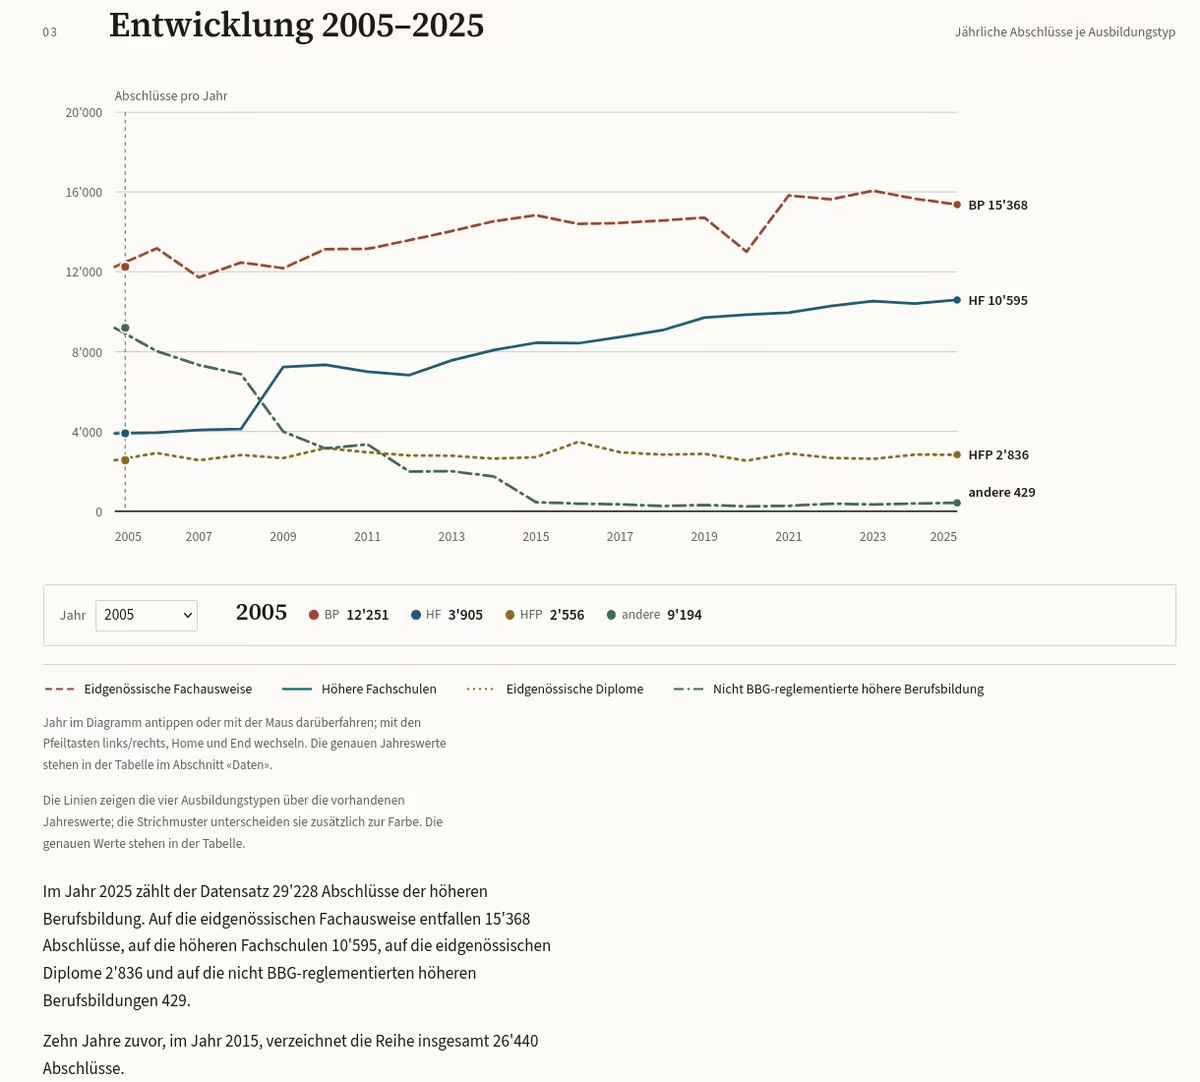
Daraus ist ein kleines Projekt entstanden: der Tertiär-B-Monitor Schweiz. Er visualisiert die Entwicklung der Abschlüsse in der höheren Berufsbildung von 2005 bis 2025 anhand offizieller Daten des Bundesamtes für Statistik. Berücksichtigt werden Berufsprüfungen, höhere Fachprüfungen, höhere Fachschulen und nicht BBG-reglementierte Abschlüsse. Ein interaktives Diagramm ermöglicht den Vergleich einzelner Jahre und Abschlussarten. Ergänzend dokumentiere ich Datenquellen, Methodik und Grenzen der Interpretation. Der Quellcode ist öffentlich zugänglich.
Die erste Version ist nun online. Geplant ist, den Monitor schrittweise um Auswertungen nach Kantonen, Geschlecht und Ausbildungsfeldern zu erweitern. Das Projekt bleibt bewusst überschaubar und soll mit jeder Erweiterung auch methodisch weiterentwickelt werden.
From other networks 8
4 likes 4 reposts
@juliansylvanor@mastodon.de shared this @CerstinMahlow@mastodon.acm.org liked this @oliklee@chaos.social liked this +5 more
Already counted in the numbers above.
Der neue BIBB-Sammelband «KI in der beruflichen Bildung – wie können wir die Zukunft gestalten?» umfasst 19 Beiträge zu Lehr-Lern-Prozessen, Weiterbildung, Prüfungen, Rollenwandel, AI Literacy und organisationalem Lernen. Schon die erste Sichtung zeigt eine erfreulich nüchterne Linie: Es geht deutlich weniger um «mehr KI-Tools» als um die Frage, wie KI fachlich, didaktisch und organisatorisch verantwortlich eingesetzt werden kann.
Einige Punkte, die ich besonders interessant finde:
AI Literacy ist mehr als Tool-Kompetenz. Entscheidend sind professionelle Urteilskraft, Selbstregulation und die Fähigkeit, KI in konkreten beruflichen Situationen reflektiert einzusetzen. Rein instrumentelle «KI-Führerscheine» greifen zu kurz, wenn sie nicht in eine breitere AI Readiness der Organisation eingebettet werden.
Menschliche Expertise bleibt zentral. KI kann Materialien erzeugen, Varianten erstellen, Informationen strukturieren oder Korrekturprozesse unterstützen. Fachliche Richtigkeit, Kontextpassung, pädagogische Qualität und Verantwortung lassen sich aber nicht einfach delegieren.
Auch die Rolle des Bildungspersonals verändert sich. Beratung, Lernbegleitung, Kuratierung, Validierung und Gestaltung von Lernprozessen gewinnen an Gewicht. Gleichzeitig findet Professionalisierung heute vielfach noch informell durch eigenes Ausprobieren statt.
Besonders spannend finde ich zudem die Beiträge zu organisationalem Lernen: KI-Transformation erscheint hier weniger als reine Technologieeinführung denn als Lern- und Gestaltungsaufgabe für ganze Organisationen.
Mein erster Eindruck: ein ausgesprochen relevanter Band für alle, die sich mit beruflicher Aus- und Weiterbildung, AI Literacy und KI-Governance beschäftigen.
Download / Publikationsseite:
bibb.de/dienst/…
From other networks 5
2 likes 3 reposts
@zwingy@troet.cafe shared this @mmedu@social.tchncs.de shared this @mmedu@social.tchncs.de liked this +2 more
Already counted in the numbers above.
Apertus im Faktencheck: 300 Testfälle zur Schweizer höheren Berufsbildung
Beim HackApertus 2026 habe ich mit Apertus Swiss HVET Eval einen domänenspezifischen Benchmark für Apertus v1.5 8B entwickelt.
Die Leitfrage war bewusst eng gefasst: Wie zuverlässig bildet ein Schweizer Sprachmodell zentrale Fakten, Strukturen, Abschlüsse und institutionelle Zuständigkeiten der höheren Berufsbildung ab?
Dafür entstanden 300 deutschsprachige Q\&A-Testfälle auf Basis von 100 verifizierten Fakten. Neben Referenzantworten umfasst der Datensatz Quellen, Metadaten, verschiedene Fragetypen und gezielt formulierte Fehlannahmen bzw. Grenzfälle.
Die wichtigsten Resultate:
-
43,3 % der 300 Antworten wurden vom automatisierten Judge als korrekt bewertet.
-
In einer manuell geprüften Stichprobe von 60 Fällen waren 31,7 % korrekt.
-
Judge und menschliche Bewertung stimmten in 75,0 % der Fälle überein.
-
Cohen’s κ lag bei 0,515.
Gerade der Unterschied zwischen automatischer und manueller Bewertung war methodisch interessant: Der LLM-Judge bewertete einige inhaltlich falsche Antworten zu grosszügig. Für Evaluationen reicht es also nicht, lediglich ein zweites Modell als „Richter“ einzusetzen – auch dessen Verhalten muss kontrolliert werden.
Das Projekt umfasst deshalb nicht nur die Modellantworten, sondern auch Quellenprovenienz, Bewertungslogik, Human Validation und einen reproduzierbaren Workflow. Mit make run lässt sich die eingefrorene Evaluation aus dem Repository reproduzieren.
Nach der Hackathon-Einreichung ist CodeFloe wieder die kanonische Quelle des Projekts. Dort sind Benchmark, Methodik, Resultate und technische Dokumentation offen verfügbar:
CodeFloe: Apertus Swiss HVET Eval
Für mich war das Projekt vor allem eine praktische Vertiefung in LLM-Evaluation, Datenqualität und reproduzierbare KI-Evaluation – und zugleich ein interessantes Fallbeispiel dafür, wie stark lokale Fachdomänen generische Sprachmodelle weiterhin fordern.
From other networks 2
1 like 1 repost
@thomasweibel@swiss.social liked this @gisiger@nerdculture.de shared this
Already counted in the numbers above.