KI

Tags 2 followers

Follow from the Fediverse

Follow #ki from Mastodon or any other Fediverse app and its public posts arrive in your timeline. No vutuv account needed.

@ki@tags.vutuv.de

Your address is used once, to send you to your own server's follow dialog. It is never stored here.

The most endorsed users with this tag

Posts with this tag

478 posts

Filters
Marquito @marquito mastodon.social

Lustig wäre ja, wenn irgendeine übermächtige #KI heraus finden würde, dass die größte Bedrohung der Menschheit Milliardäre sind und sie nur diese vernichten würde. Danach würde deren Reichtum dann gleichmäßig auf die restlichen Menschen verteilt, die dann friedlich in gesichertem Wohlstand leben können.

MIT Technology Review DE @techreview_de social.heise.de

Da KI-Agenten in kritischen Sektoren zum Einsatz kommen – von Finanzen über Behörden bis hin zur Medizin –, müssen wir aber in der Lage sein, sie in Echtzeit zu überwachen. Nur so können wir weitreichende und potenziell verheerende Folgen verhindern. (+)

#KIagenten #KI

t3n.de/news/…

Bundesdigitalministerium @BMDS social.bund.de

Heute startet der #DigitalGipfel unter dem Motto „Shaping AI: safe, sovereign, competitive“ und Ihr könnt dabei sein! 🎥

👉🏻 Und zwar über den Livestream auf bmds.bund.de/aktuelles/…

In Berlin empfängt Bundesdigitalminister Karsten Wildberger am ersten Tag internationale Gäste aus Wirtschaft, Wissenschaft, Gesellschaft und Politik.

Darunter Digitalministerinnen und -minister aus Europa und Kanada.

BMDS Digitalministerium WirMachen KI KünstlicheIntelligenz DigitaleSouveränität
Anne Quinkenstein @quinkensteina blog.tib.eu

The Cost of Knowledge, revisited: Gefährdet KI die Infrastruktur offenen Wissens?

Die berühmt-berüchtigte PHP-Sicherheitslücke und deren Schließung in betroffenen Servern und Anwendungen hat auch die TIB herausgefordert, und damit TIB Blog und unsere Blogreihe zur OAWeek26 tagelang beeinträchtigt. Aber für uns ist eigentlich immer Open Access Week. Daher kommt dieser Post zwar um gut eine Woche zeitverzögert, ist aber nicht minder aktuell.

Im Zuge des KI-Booms greifen immer mehr Unternehmen auf Open-Access-Repositorien und andere Angebote von Bibliotheken und Archiven zu, um damit ihre Sprachmodelle zu trainieren. Dass Programme (Bots) Repositorien automatisch abrufen, ist an sich nichts Schlechtes, sondern sogar erwünscht: Diese sogenannten Crawler lesen die Seiten und sorgen zum Beispiel dafür, dass Publikationen über Suchmaschinen wie z.B. Google und Google Scholar auffindbar sind. Aggressiv programmierte Crawler setzen Repositorien jedoch zunehmend unter Druck, und das Problem ist in den letzten zwei Jahren stark gewachsen. Diese Bots ignorieren die Regeln, die eine Website für automatische Besucher:innen festlegt, etwa welche Seiten sie besuchen sollen oder wie lange sie zwischen den Zugriffen warten sollen. Diese Regeln stehen in einer Datei namens robots.txt, einer Art Hausordnung für automatische Besucher:innen. Die Bots schicken ungeachtet der Regeln in kürzester Zeit tausende Anfragen. Die Wirkung gleicht einem gezielten Überlastungsangriff (Fachsprachlich DDoS, kurz für „Distributed Denial of Service“ Ein Server wird von vielen Stellen gleichzeitig mit Anfragen überflutet, bis er nicht mehr antworten kann.), auch wenn meist keine böse Absicht dahintersteckt. Die Server kommen nicht mehr hinterher und brechen im schlimmsten Fall zusammen. Für die Menschen, die das Repositorium nutzen wollen, lädt die Seite dann quälend langsam oder gar nicht mehr.

Offen heißt nicht kostenlosDie Zahlen sind deutlich: In einer Umfrage des internationalen Repositorien-Verbunds COAR (Confederation of Open Access Repositories) gaben 2025 über 90 % der Repositorienbetreibenden an, regelmäßig mit aggressiven Bots zu kämpfen. Die Dokumentationsplattform Read the Docs musste wegen eines einzigen Crawlers mehr als 5.000 Dollar zusätzlich für Datenverkehr bezahlen. Auch bei uns an der TIB waren Website und Repositorien aufgrund von aggressiven Crawlern schon mehrere Tage lang nicht erreichbar.

Die eigentlichen Kosten tragen dabei die Betreibenden:

Technik und Energie für Serverlast, von der Menschen zunächst gar nichts haben

Arbeitszeit von Mitarbeitenden in Bibliotheken und Rechenzentren, die in die Abwehr fließt statt in die Weiterentwicklung und denen damit Zeit für anderes fehlt

Kollateralschäden, wenn Schutzmaßnahmen versehentlich echte Nutzer:innen aussperren wie zB Bilderrätsel (CAPTCHAs) die Menschen mit Sehbehinderungen den Zugang erschweren

Datenschutzfragen, weil man zum Erkennen von Bots das Verhalten der Besucher:innen auswerten muss

Ansehensverlust, denn wenn ein Angebot ausfällt, wird das selten den Bots, sondern meist der Einrichtung angelastet

Warum Scraper so aggressiv sindHinter dem Ansturm steckt zum einen der KI-Hype: Wer ein Sprachmodell trainieren oder auf dem neuesten Stand halten will, braucht riesige Mengen guter Texte. Es ist ein regelrechter Datenmarkt entstanden. Spezialisierte Firmen sammeln im Auftrag anderer Inhalte aus dem Netz ein und verkaufen sie als fertige Datenpakete weiter. Sie verfügen über große Netzwerke und eigene Fachteams, mit denen sie ihre Herkunft verschleiern. Für sie zählen Menge und Tempo. Rücksicht auf die Server, von denen sie die Daten holen, kostet sie nur Zeit. Sich an die Hausordnung einer Website zu halten, bringt ihnen keinen Vorteil.

Hinzu kommt, dass gerade das, was kuratierte Sammlungen auszeichnet, sorgfältige Beschreibungen, offene Lizenzen, fachliche Qualität und eine klare Struktur, sie zu begehrten Trainingsdaten macht. Große Organisationen wie Wikimedia können darauf reagieren: Mit Wikimedia Enterprise bietet die Stiftung hinter Wikipedia einen offiziellen, kostenpflichtigen Zugang an, der ihre Daten maschinenlesbar aufbereitet zur Verfügung stellt, den inzwischen unter anderem Amazon, Meta und Microsoft nutzen. Einzelne Repositorien haben diese Verhandlungsmacht nicht. Es gibt aktuell Initiativen wie OpenAIRE, die Daten aus vielen Repositorien bündeln und eigens für Maschinen aufbereitet anbieten. Der „OpenAIRE AI Service“ etwa stellt diese Daten über MCP bereit, eine standardisierte Schnittstelle, über die KI-Anwendungen gezielt Informationen abfragen könnten. Die Crawler grasen weiterhin jedoch lieber die für Menschen gemachten Webseitenoberflächen ab und die Belastung für Repositorien ist kaum zurückgegangen.

Die naheliegende Reaktion, Inhalte hinter Logins oder Bezahlschranken zu verstecken, wäre ein Rückschritt hinter alles, wofür die Open-Access-Bewegung gekämpft hat. Sie würde ausgerechnet jene treffen, für die Repositorien gemacht sind. Und sie schützt die Inhalte nicht einmal zuverlässig: Wo Texte hinter Bezahlschranken liegen, etwa bei Verlagen, werden sie oft genug an Datenhandelsfirmen und KI-Unternehmen verkauft.

Für den Open-Access-Bereich bleibt damit ein echter Widerspruch. Wir stehen dafür, Wissen für alle zugänglich zu machen und Barrieren abzubauen. Gleichzeitig gefährden massenhafte automatische Zugriffe genau die Systeme, die diese Offenheit erst möglich machen. Die Wikimedia Foundation hat das auf die Formel gebracht: „Our content is free, our infrastructure is not.“ – unsere Inhalte sind frei, unsere Infrastruktur ist es nicht (Wikimedia Foundation 2025). Wir in der IT sind zunehmend mehr damit beschäftigt, die Verfügbarkeit dieser Infrastruktur auf Dauer verlässlich sicherzustellen.

Ein Katz-und-Maus-SpielDie Abwehr ist ein ständiger Wettlauf, bei dem die Crawler meist am längeren Hebel sitzen: Sie haben mehr Geld, mehr Rechenleistung und mehr Personal als eine Bibliothek, die ihr Repositorium neben vielen anderen Aufgaben betreibt. Und die Lage ändert sich laufend. Lange half es, die Absenderadressen (IP-Adressen) zu sperren, von denen die Anfragen kamen, meist große Rechenzentren und Cloud-Anbieter. Inzwischen laufen viele Crawler über sogenannte Residential Proxies: Sie nutzen die Internetanschlüsse von Privathaushalten mit. Möglich machen das zum Beispiel kostenlose Smartphone-Apps oder Smart-TVs, über die deren Anbieter:innen die Internetverbindung ihrer Nutzer:innen gegen Geld weitervermieten. Oder es sind gekaperte Geräte wie Router und Überwachungskameras, die zu sogenannten Botnetzen zusammengeschlossen werden. Die Anfragen kommen dann von ganz normalen Heimanschlüssen, und für den Server sieht es aus, als würden Tausende echte Menschen die Seite besuchen. Wer diese pauschal sperrt, trifft immer auch menschliche Nutzer*innen.

Auch die nächste Verteidigungslinie hält nicht lange. Schutzprogramme wie Anubis lassen den Browser vor dem Zugriff eine kleine Rechenaufgabe lösen. Ein einzelner Mensch merkt davon nur eine kurze Verzögerung. Bei Crawlern mit Millionen automatischer Abrufe summieren sich diese Verzögerungen dagegen zu echten Kosten. Doch Werkzeuge, die genau diese Hürde gezielt umgehen, sind längst frei im Netz verfügbar. Jede Schutzmaßnahme ist nur ein Zwischenstand, auf den die Gegenseite reagiert.

Trotzdem gilt es, rücksichtslose Zugriffe auf unsere Systeme so weit einzuschränken, dass Menschen und gewünschte Bots weiterhin zugreifen können, ohne die Falschen mit auszusperren. Eine Patentlösung gibt es nicht. Gebraucht wird eine gut begründete Auswahl von Maßnahmen, die die Last durch automatisierte Zugriffe wirksam begrenzen und zugleich mit Offenheit, Barrierefreiheit und Datenschutz vereinbar sind. Diese Auswahl muss zudem laufend überprüft und angepasst werden. Als 2012 tausende Forschende unter dem Motto „The Cost of Knowledge“ gegen die Preispolitik des Verlags Elsevier protestierten, lautete die Frage: Wer kann es sich leisten, Wissen zu lesen? Open Access war nie kostenlos, aber der Protest hat geholfen die Kosten besser zu verteilen. Wenn das so bleiben soll, brauchen wir technische Lösungen, die Offenheit schützen statt sie einzuschränken, und eine Debatte darüber, wie diese Infrastruktur künftig bereitgestellt werden soll.

Repositorium KI OpenAccessWeek2026
Logo der International Open Access Week und verzerrter Computermonitor mit dem Text "DISCONNECTED".
Kuketz-Blog 🛡 @kuketzblog social.tchncs.de

Eric Schmidt fordert junge Menschen auf, beim KI-Hype mitzumachen. Dabei sorgen sie sich gerade wegen dieser Entwicklung um ihre Zukunft. Wer von einer Technologie profitiert, darf die Verantwortung für ihre Folgen nicht einfach der nächsten Generation überlassen. Die Erzählung, KI lasse sich nicht durch Gesetze regulieren, spielt vor allem Big Tech in die Hände. 👇

kuketz-blog.de/kommentar-die-bedrohte-z…

Bernhard Biedermann @Bied digitalhub.social

Zweifel ob sich die Investitionen in künstliche Intelligenz lohnen werden? 😔

Die Überschrift #KI-Sorgen:

“KI-Sorgen treiben Anleger aus Tech-Aktien”

Merkwürdig erscheint mir, dass es erst jetzt klar wird, ein #ROI ist bei #KI nicht zu erwarten.

Nachdem seit mehr als einem Jahr verschiedene Medien deutlich gewarnt haben fangen nun auch die Zocker an der Börse sich Gedanken zu machen. 😔

Wo bleibt denn die Aussage: “Geld wird überflüssig” wenn es doch relevant ist? 😁

Ein Beispiel, für eine “Korrektur”:

“Intels Aktienkurs brach um fast 29 Prozent ein und fiel damit auf das Niveau vom April 2026 zurück.”

Die Risse in der Mauer des Glaubens an #KI wird es schon richten, werden größer. Es könnte sein, dass es jetzt Zeit ist sich ernsthafte Gedanken, über die Sicherheit des Betriebs, zu machen.

♦️ Die “digitale Souveränität” sollte an erste Stelle kommen.
♦️ Ferne Dritte “aus der Linie entfernen”,
♦️ die #Cloud-Angebote hinterfragen,
♦️ die eigene Sicherheit an erste Stelle stellen und
♦️ den Versprechungen misstrauen,

das alles halte ich für sehr ratsam.

Die seriösen Lösungen die #KI vor allem lokal nutzen werden, so hoffe ich, den Sturm überstehen, aber Vorsicht ist trotzdem angebracht.

Die Verzahnung von #Cloud und #KI wird vermutlich massive Auswirkung auf die Preise bei (ferner) Cloud haben. Denn wenn die Korrektur einsetzt werden die Rechenzentren erhebliche Einbußen beim Umsatz erleiden (und abwenden wollen). Die Kunden die keine Vorsorge getroffen haben, zahlen dann den Preis für das Versagen der Konzerne.

Wer jetzt Vorsorge trifft, der ist deutlich besser drann als die #KI-Gläubigen, die meinen es wird schon nicht so schlimm werden. 😔

Sprechen Sie mit einem Spezialisten oder guten #MSP wie man sicher und erfolgreich die “digitale Souveränität” nutzt um sein Geschäft erfolgreich, auch in stürmischen Zeiten, weiter zu betreiben. 🙂

golem.de/news/…

Christoph Schmees @PC_Fluesterer social.tchncs.de

KI-Regulierung in Australien

Die australische Regierung arbeitet an einer Internet-Regulierung, die möglichst noch in diesem Jahr verabschiedet werden soll. Dies ist nach meiner Kenntnis der erste Gesetzentwurf für eine solche Regulierung, der jedenfalls vom Wortlaut und von der Absicht her wirklich Biss hat. Der Teufel steckt aber bekanntlich im Detail: Wie Verstöße entschieden werden sollen und wie die Verbote durchgesetzt, muss sich erst noch zeigen. Das Gesetz soll gelten für
die kommerziellen antisozialen Plattformen,
Spiele,
Apps,
KI Chatbots.

… Weiterlesen:

pc-fluesterer.info/wordpress/…

KI & Koffein @ki_und_koffein ard.social

Habt ihr in den letzten Tagen auch so wilde Bilder bei Lieferando gesehen? Die KI hat aus Beschreibungen die absurdesten Albtraum-Gerichte gezaubert:

lieferando ki fails techTalk
Christoph Schmees @PC_Fluesterer social.tchncs.de

KI gegen Demokratie

Dieser Fall führt uns wieder auf die britische Insel. Dass, und auf welche Weise, KI den Politischen Diskurs und damit die Demokratie bedroht, habe ich schon mehrfach beschrieben. Im Jahre 2023 wurde über einen Gesetzentwurf diskutiert, der unter anderem Wegwerf-Vapes (Einweg-E-Zigaretten) verbieten sollte. Dazu erreichten das britische Gesundheitsministerium 118.756 Stellungnahmen, von denen ein großer Teil verdächtig nach automatisiert roch. Wie groß der gefälschte Anteil war, hat eine nachträgliche wissenschaftliche Untersuchung ergeben, die jetzt veröffentlicht wurde. Demnach waren drei Viertel (genau 76%) der Eingaben das Werk von Automaten (Bots). Die Inhalte gleich lautend oder … Weiterlesen:

pc-fluesterer.info/wordpress/…

fake KI politik verbraucherschutz
Bernhard Biedermann @Bied digitalhub.social

Die #Server-Sicherheit und ein Root-Exploit. 🙂

Durch die intensiveren Test mittels #KI finden sich auch remote ausnutzbare Sicherheitslücken. 🔥

CVE-2026-98432 CVSS 9.8

Ursache:

“Bei dem Fehler handelt es sich um eine Race Condition im Code, der neue IPv4-TCP-Verbindungen aufbaut. Bei ungünstigem Timing kann der Kernel auf bereits freigegebenen Speicher zugreifen. Diese Fehlerklasse wird als Use-after-free bezeichnet. IPv6 scheint nicht betroffen zu sein, da der Kernel die relevanten Optionen bei diesen Verbindungen kopiert.”

Die Kernel Entwickler haben den Fehler ab 04.10.2026 gehoben. Allerdings sind aktualisierte Kernel nicht immer sofort verfügbar. Nur wer in der Lage ist seinen eigenen Kernel einzustellen und zu kompilieren, der kann sicherer sein. 👍

#Gentoo-Nutzer sind da in einer guten Position, denn bei dieser Distribution ist dies der “normale” Weg. 😊

Wer die #IT-Sicherheit und die “digitale Souveränität” für den richtigen Weg hält sein Unternehmen zu beschützen, fragt einen erfahrenen Spezialisten.

Es gibt gute Lösungen die auch noch preiswert sind und komplett ohne ferne Dritte auskommen. 🙂

golem.de/news/…

Bernhard Biedermann @Bied digitalhub.social

#Clickbait und #KI, oder wie wichtig ist es wirklich? 😔

Die Meldung war ja von besonderer Zielrichtung - “Millionenfach installierte Cursor-Erweiterung kompromittiert”

Prüft man die Botschaft, dann stellt sich raus, ja es gab einen Fehler, nur der war überschaubar:

“Betroffen ist aber wohl nur die Variante im Marktplatz des KI-gestützten Code-Editors Cursor, wo die kompromittierte Version der Claude-Code-Erweiterung zeitweise verfügbar war. Dort soll sie nach Angaben des Plattformbetreibers “höchstens 5.000 Benutzer” erreicht haben.”

Und kaputt war die Backdoor auch noch:

“Die Backdoor hatte jedoch einen Logikfehler, wodurch sie in der Regel nicht wie von den kriminellen Drahtziehern erhofft lief.”

“Cursor zufolge stammt die manipulierte Version 2.1.313 nicht von Anthropic, sie war zwischen 10:27 und 21:35 Uhr mitteleuropäischer Zeit am Donnerstag online; laut Reuters sind bis zu 5000 Nutzer betroffen.”

Wie bei allem, wer sich mit Dritt-Software beschäftigt, der sollte über Erfahrung verfügen. Nicht immer sind die “ganz neuen” Features und Versionen vertrauenswürdig.

Erfahrene Spezialisten sind immer eine gute Anlaufstelle um mehr Sicherheit mit #KI zu erhalten. 🙂

heise.de/news/…

KI Clickbait

Ja wo denn jetzt - Europa oder International?

Interessante Zahl aus dem EuroCloud Pulse Check 2026: 250 deutsche Unternehmen wurden befragt, wo sie #KI betreiben.

Heute: 54 Prozent auf Hyperscalern, 40 Prozent auf europäischen Clouds.

Geplant für die nächsten zwei Jahre: 53 Prozent europäisch, 48 Prozent #Hyperscaler. Die Reihenfolge dreht sich also.

Das ist sicherlich keine Abkehr von AWS und Co, eher Arbeitsteilung: Standard-KI-Dienste laufen dort, wo sie bereits verankert sind. Sensible Modelle und Daten gehen dorthin, wo Rechtsraum und Kontrolle stimmen.

Der Haken: Vertrauen reicht nicht. Europäische Anbieter verlieren auch diese Chance, wenn Integration und Leistung nicht mithalten. 33 Prozent der Befragten nennen technische Integration auch bei europäischen Anbietern unter den Top-Erwartungen.

#DigitaleSouveränität öffnet die Tür. Über die Schwelle gehen nur Angebote, die im Betrieb überzeugen.

cbollert @cbollert social.detektor.fm

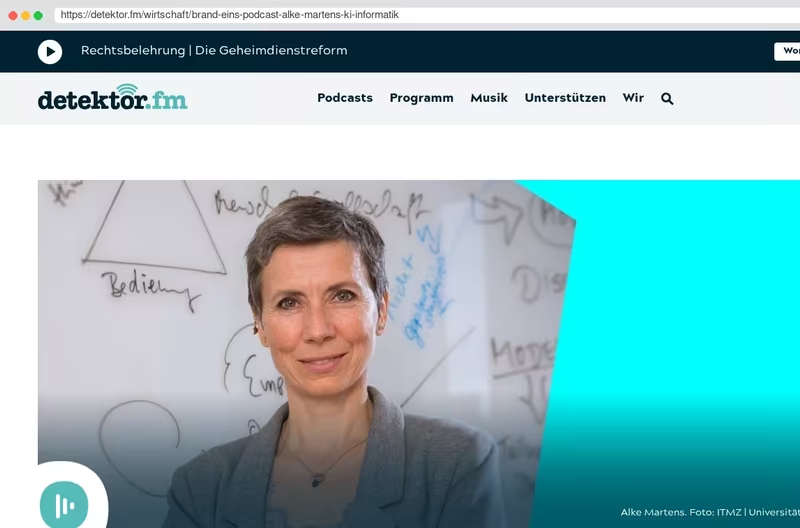
“Die KI-Blase platzt leise”, prognostiziert die Professorin @alke_martens@mastodon.social von der Uni Rostock im brand eins Podcast bei @detektorfm@social.detektor.fm . Aus ihrer Sicht braucht es für produktive Ansätze ganz neue technische Ansätze, die über Sprachmodelle hinausgehen.

Die Kombination mit politischer Macht ist für Alke Martens ein Grund für die Stärke der Tech-Konzerne. Sie plädiert insbesondere dafür, keine kreativen Arbeiten mit KI zu machen.

detektor.fm/wirtschaft/…

Christiane Schulzki-Haddouti @SchulzkiHaddouti reporter.social

Wölfe in den Dörfern, Schlamm in den Flüssen: Der Skandal um die Rechenzentren von #Google in #Finnland ist beispielhaft für den wachsenden Konflikt um den Ausbau von Künstlicher Intelligenz.

Finnland will insgesamt 154 Rechenzentren aufbauen. Google 13 Milliarden € investieren und man darf gespannt sein, wie die Behörden mit den Folgen massiven Abholzung auf 500 Hektar jetzt umgehen.

riffreporter.de/de/… #KI @riffreporter@mastodon.social

Zentrum für digitale Teilhabe @zendit bizzfed.de

Anfrage für eine Betriebsratschulung eines Sozialkonzerns für alle Betriebsräte zum Thema Ki Nutzung innerhalb des Konzerns.
Da braucht man erstmal einen dritten Kaffee am frühen Morgen. ☕☕☕

vollcool ki sozialwirtschaft ohneBild
Bernhard Biedermann @Bied digitalhub.social

Fakes und andere alternative Fakten. 😔

Die Berichte über #KI und #Cloud reißen nicht ab. Jeden Tag werden Erzählungen über die Neuheiten verbreitet als gäbe keine Fehler. 🔥

“„Sie lügen ja nicht, sondern sie dehnen den Begriff der Wahrheit“, erklärte Thür über die Kommunikationsstrategien von Politikern.”

Die Spaßgesellschaft steht einen Schritt vor dem Abgrund, also lasst uns mutig einen Schritt nach vorn tun. 👍

“„Trotz der KI-Technologie ist das eigentlich noch immer der Nummer-eins-Trick, wie man Leute hinters Licht führt“, sagte Winter über echte Videos, die in einem falschen Kontext neu gepostet werden.”

Ob Politik oder Technik, die Methoden sind die Gleichen. Gut bei #KI und #Cloud geht es vielleicht noch märchenhafter zu, nur verstehen die meisten Bürger die Fremdwörter nicht und “glauben” deswegen.

“Wie resistent manche Menschen inzwischen gegen Fakten sind, zeigte Brodnig anhand einer Anekdote: Eine Frau war auf eine erfundene Geschichte über angebliche Pläne Deutschlands zur Aufnahme von Millionen Flüchtlingen hereingefallen. Als Brodnig sie mit der Wahrheit konfrontierte, hatte sie eine Ausflucht parat: „Das war jetzt nicht wahr, aber wer garantiert mir, dass es nicht in fünf Jahren wahr ist?“ Selbst Brodnig war da sprachlos.”

Im Bereich #IT, gibt es jedoch erfahrene Spezialisten die helfen können eine solide Basis zu schaffen. Einfach fragen, dann klappt es auch. 😊

profil.at/events/…

tagesschau @tagesschau ard.social

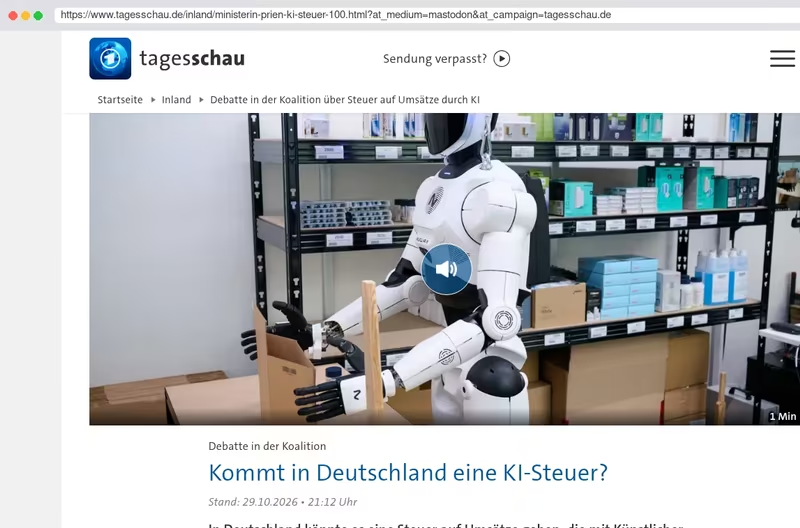
Debatte in der Koalition über Steuer auf Umsätze durch KI

In Deutschland könnte es eine Steuer auf Umsätze geben, die mit Künstlicher Intelligenz erzielt werden. Auch Familienministerin Prien sprach sich nun dafür aus. So soll auf Veränderungen in der Arbeitswelt reagiert werden - zum Beispiel auf Jobverluste.

➡️ tagesschau.de/inland/…

KI Steuer Prien KünstlicheIntelligenz

Keyboard shortcuts

Navigation

Home g h
Feed g f
Messages g m
Notifications g n
Your profile g p
Search /

Actions

Write a new post n
Send the post or message you are writing ⌘/Ctrl ↵
Next post in the feed j
Previous post in the feed k

General

Show this help ?
Close menus and dialogs Esc

The single-key shortcuts pause while you type, and are off on phones and tablets.