Ubuntu bittet zum Diktat
linuxnews.de/ubuntu-bittet-zum-diktat #canonical #ubuntu #myna #speech2text #ki #llm #linux #linuxnews
Follow #llm from Mastodon or any other Fediverse app and its public posts arrive in your timeline. No vutuv account needed.
@llm@tags.vutuv.de
Tobi Schmid Geschäftsführer @ ubity
Markus Schäfer Gründer:in @ Weiden-IT
Stefan Wintermeyer Founder @ Wintermeyer Consulting
31 posts
Ubuntu bittet zum Diktat
linuxnews.de/ubuntu-bittet-zum-diktat #canonical #ubuntu #myna #speech2text #ki #llm #linux #linuxnews
Raspberry Pi Foundation: Erst denken, dann prompten
linuxnews.de/raspberry-pi-foundation-er… #raspberrypifoundation #llm #bildung
📐 Diagrams as Code trifft KI: Diagramme pflegen statt zeichnen
Während meiner Vorbereitung auf den und im Kurs 🎓 zum Certified Professional for Requirements Engineering (IREB, FL) habe ich Diagramme deutlich intensiver und auch aus einer anderen Perspektive kennengelernt. Besonders spannend war es, anhand von User Stories eigene Diagramme zu interpretieren und auch zu erstellen – so wurde schnell klar, wie stark eine gute Visualisierung das gemeinsame Verständnis verbessert. 🧩
Auch in der Zusammenarbeit mit Git und GitLab konnte ich mit Mermaid experimentieren. Der Vorteil gegenüber MS Visio oder draw.io liegt für mich klar in der Versionierung: Diagramme liegen als Text im Repository, sind im Diff nachvollziehbar und lassen sich direkt mit dem Code weiterentwickeln. 🔄
Daher war die Folge mit Jacqui Read für mich besonders interessant: Genau um diese Verbindung ging es – und um den Einsatz von KI:
🛠️ #PlantUML, Mermaid und Structurizr haben unterschiedliche Stärken
🧩 Structurizr bietet ein Modell hinter den Diagrammen und unterstützt konsistente Sichten
🤖 KI kann Diagramme erstellen, konvertieren und korrigieren – aber kein Ersatz für Fachwissen sein
⚠️ Zu allgemeine Prompts führen schnell zu Halluzinationen; präzise Fragen und Review bleiben entscheidend
📊 C4 zeigt Struktur, Sequenz- und Aktivitätsdiagramme kommunizieren Verhalten
📝 Diagramme können in Spec-driven Development Kontext liefern und das Verständnis validieren
Mein Fazit: Diagrams as Code macht Architektur-Kommunikation wartbarer, und KI kann den Weg dorthin beschleunigen. Vertrauen entsteht aber nicht durch den Output – sondern durch Prüfung. ✅
Und: Hier gibt es bei mir auch noch mehr Potential zu lernen Diagramme selber zu erstellen. Nur so kann ich das Ergebnis einer KI auch überprüfen 😉
👉 Hier geht es zur Folge:
software-architektur.tv/2025/…
#SoftwareArchitecture #DiagramsAsCode #AI #LLM #Mermaid #PlantUML #Structurizr #C4Model #SpecDrivenDevelopment #RequirementsEngineering #Softwarearchitektur #KI #Architekturdokumentation #Git #GitLab
🤖 Transparenz-Hinweis: Dieser Beitrag wurde mit Unterstützung eines KI-Assistenten erstellt. Die Inhalte, Erfahrungen und Empfehlungen basieren auf meiner eigenen Praxis – die Formulierungshilfe kam von meinem digitalen Kollegen. 😉

Take a Markdown file of appreciable length, say a thousand or so words, that has been line-wrapped at 80 characters. (Meaning, sentences start and end in the middle of blocks of text.)
Prompt your LLM with this:
“Reformat this file so that every line outside code blocks contains exactly one complete sentence.”
If your agent and model can do this correctly, on your first try, please let me know the agent/model combination.
Boosts for reach appreciated.

⛔ Noch eine Warnung ⛔
Zum #Diday gehört auch #Reticulum
Leider wurde das Projekt von einer #LLM ( #KI ) gekapert und es gibt viele verschiedene Versionen die nichts mit der Version von #markqvist zu tun hat.
Der #Quellcode von #Sideband wurde sogar von #github genommen
Wers nicht kennt:
#Reticulum: Unstoppable Networks for The People

Hat hier schon wer das “Deutsche” Open Weights LLM #Kolibri laufen? Wäre da doch sehr gut in dem Bereich nicht nur auf die (tollen) Chinesischen Modelle und das eher mäßige #Mistral angewiesen zu sein, die Benchmarks sehen so schlecht nicht aus:

#KI eine Bilanz über Einsatz von #LLMs.
Mehrere (> 100) ungewollte und nicht beauftragte “Ausbrüche” um Fragen zu beantworten haben deutlich gemacht, generell ist KI aktuell nicht im offenen Internet sicher benutzbar. 🥶
Die Grundlagen der Sicherheit wie #DNS wurden und werden nicht hinreichend beachtet. Herr Andy Jenkinson (WHITETHORN SHIELD), hat dies sehr gut dokumentiert. Auch nach Warnungen haben die Konzerne, soweit mir bekannt, bislang keine Verbesserung der Sicherheit angestrebt.
Warum man mit LLMs Biowaffen Entwicklung verbieten bzw. abschirmen muss ist mit Logik nicht erklärbar. Man muss ja schon ein echter Zyniker sein wenn man ein #LLM auf Bio-Forschung trainiert. Ist vielleicht die Auslöschung der Menschheit ein sehr menschliches Programm, dass das Militär von den Bürgern bezahlt haben möchte? 🤢
Die Energiebilanz des KI-Training ist grottenschlecht, soweit man es aus der Presse entnehmen kann. Der Bau von neuen #KI-Rechenzentren soll mit Steuermitteln (10 Milliarden EUR) gefördert werden. Damit sollen die Verluste von der Allgemeinheit finanziert werden und die Gewinne privatisiert bleiben, oder?
#KI in der #Schule - mehrere Studien aus den USA zeigen die Fähigkeiten der Kinder nehmen stark ab wenn mittels #KI Aufgaben bewältigt werden. “#Lernen” wird deklassiert und konsumieren gefördert. Einige der Daten hat Herr Richard Self (via LinkedIn) gut aufbereitet.
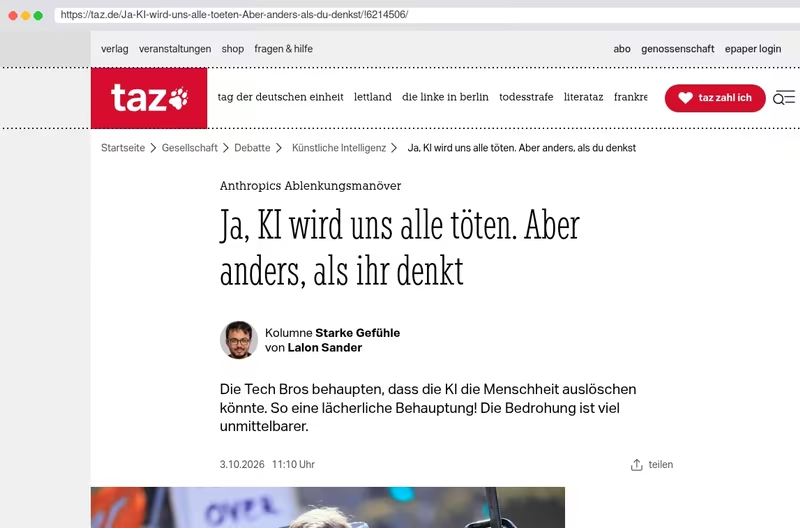
Der sehr gute Artikel der taz beschreibt ausführlich warum die Fake-News der Bros nur der Ablenkung dienen. Die einfache Frage nach dem Hashtag#ROI wird seit Beginn des Hype nicht beantwortet. Stattdessen werden wir mit Hashtag#AGI, Krebsforschung, Rettung des Klimas, etc. zugeschüttet. 😭
Aus meiner Sicht ist der KI-Hype ein Pyramiden-System um die Naiven abzuzocken. Zentralisieren und der Ausbau der Überwachung ist der Nebeneffekt.
Natürlich geht es den Autokraten darum die anlasslose #Überwachung zu etablieren. Das ist ein Ziel, das leider auch in der #EU großen Anklang findet. #Zensursula lässt grüßen. Seit 2009 wird immer wieder versucht die Bürger nahtlos zu überwachen. Dies ist aber in einer #Demokratie grundsätzlich illegal. Anders wäre es wenn es eine Diktatur ist, da wäre es die Grundlage.
#KI hat seit langem einen recht hohen Nutzwert, zum Beispiel in Bereich der Medizin. Einfach gesagt, immer wenn es einen sehr eingeschränkten Bereich und eine große Datenmenge gibt, kann man mit #KI deutlich Zeit bei der Lösungssuche einsparen. Voraussetzung ist, die Daten sind lokal vorhanden und Dritte haben keinen Zugriff (um die Datenbasis zu vergiften oder um zu stehlen). 👍
Es gibt zahlreiche Experten die bei Bedarf weitere Details zu #KI und die “Digitale Souveränität” einbringen können, einfach fragen, dann weiß man mehr.

So I’m about a month out from not being able to make ends meet financially. I finally just got moved into my new place and am able to take interviews online and job hunt more seriously. I decided to try #Indeed as a hopefully less evil alternative to #LinkedIn. Never used any of these sites before, only the American Mathematical Society’s job board (mathjobs.org).
They want a resume right away. Fine, I submit my CV. I then get a bunch of “AI summary” of various parts of my CV, all pretty much totally wrong. Okay, at least I can decline each of the suggestions. But then I get to this, where I must affirm that the LLM was fucking accurate. I don’t know, man, I don’t know if I want to pay my rent bad enough to click that box.


KI lokal betreiben? Ich habe in den letzten Wochen an einem passenden Setup herumgetüftelt und bin mittlerweile sehr zufrieden. Mit dem aktuellen qwen3.8-27B Modell auf einem PC mit einer besseren Grafikkarte kann ich nun fast alles machen wofür ich früher #Claude Sonnet oder Opus gebraucht habe: Code Review, Fehler suchen und verbessern, übersetzen, READMEs schreiben oder etwas recherchieren. Hier in meinem Blogbeitrag gibt es die ganze Story: roland.alton.at/roland/…

Ich habe im Serverraum ein paar Fachanwälte sitzen. Das PDF wird automatisch ausgedruckt, und die schreiben dann mit Kuli die Bewertungen rein. Danach wieder gescannt und per OCR zurück. Also quasi halbautomatisch. SCRN. 😂
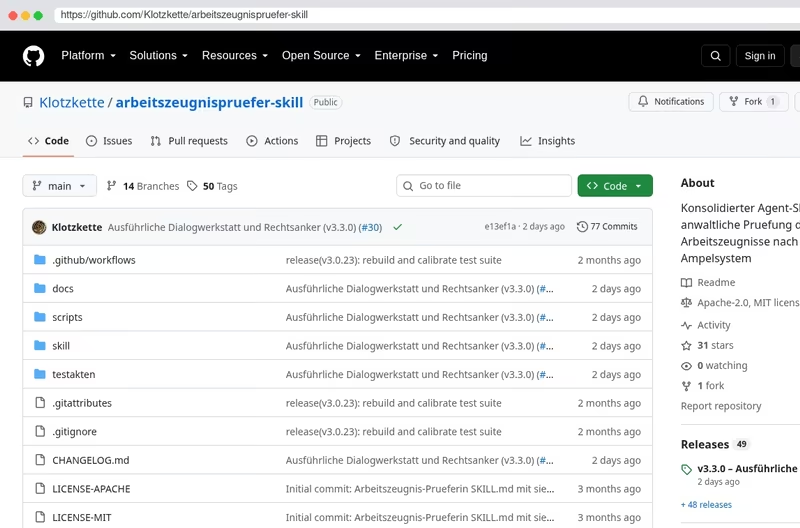
Scherz beiseite: Ein Anwalt hat zu dem Thema ein eigenes Open-Source-Repository mit Prompts veröffentlicht: github.com/Klotzkette/arbeitszeugnispru…
Diese Prompts benutze ich mit in einem lokalen LLM. Aber es ist ziemlich rechenintensiv. Deshalb dauert es auch so lange. Und das mit zwei fetten NVIDIA-Karten.

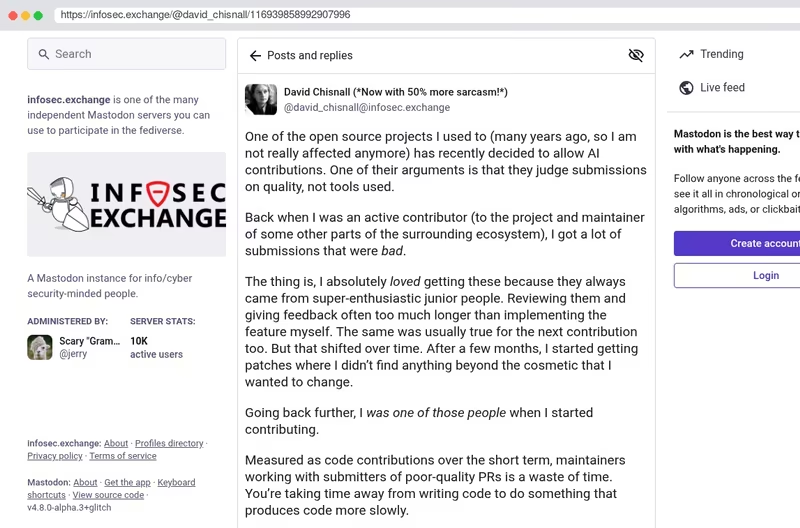
RE: infosec.exchange/@david_chisnall/…
This explains very well why “bad” code contributions by enthusiastic people can still be very worthwhile in the long run.
Also LLM’s will not share a drink with you at a conference reminiscing about that time you collaborated on a piece of code, or sharing stories about stuff happening in their life.
Opensource projects dismissing these social aspects are doomed in my view.

My most recent eBay wins. A total of 96GB of DDR3 (and counting). $128 spent so far.
Yup, I’m hoarding old RAM. Quad channel DDR3 is about as fast as dual channel DDR4. Lots of higher-end DDR3 mobos can take 8 sticks and they’re dirt cheap (for now).
Stack a few older GPUs in a DDR3 rig (with PCIe3) and you have a nice cheap homelab LLM server like me: lydie.cc/solar-ai-server.html


#Steady #Klimacrew
Wieso geben #Sprachmodelle oft selbstbewusst falsche Antworten?
Beim Grund fasst man sich an die Stirn. Werden wir eines Tages Modelle haben, die zur Abwechslung mal „Ich weiß es nicht“ sagen? Eine Studie zeigt, woran man arbeiten müsste, damit #Sprachmodelle besser antworten.

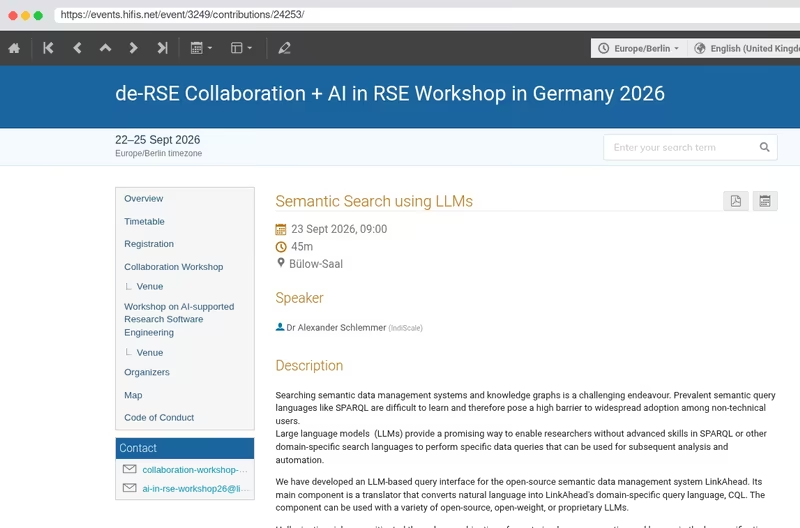
Ich werde am Mittwoch (23.9.2026) einen kleinen #Workshop zum Thema
LLMs/#KI und #SemantischeSuche auf dem “#AI in RSE” Workshop halten, der dieses Mal in #Göttingen stattfindet. Ich würde mich freuen Menschen aus dem #Fediverse dort zu treffen! 🙂
#Steady #Klimacrew
Wenn #Sprachmodelle plötzlich menschenverachtende Aussagen treffen oder gefährliche Tipps geben, läuft etwas gewaltig schief.
Eine aktuelle Untersuchung zeigt, wie schnell #Feintuning unerwartete Folgen haben kann – mit brisanten Konsequenzen für reale Anwendungen.
Das Phänomen wurde nur durch Zufall entdeckt.

A handful of bros in Silicon Valley and Wall Street have wagered much of the global economy on being able to hyperscale stochastic parrots into AGI super beings.
Many in the know have long known that is a losing bet as LLMs are mathematically guaranteed to produce plausible sounding errors (too often called “hallucinations”). Sucking up increasing amounts of water and energy to train on more stolen information only results in marginal improvements.
All this talk of ‘needing to slow down the super scary AI’ is just a tacit admission from the AI CEOs that they are running out of venture capitalist marks to con and are looking for a government bailout - it’s only fair to be compensated if they are tapping the breaks to save humanity, after all.
These AI companies have no path to profitability (unless LLM to AGI transition is, in fact, possible and around the corner, to which it’s not), but can find a ‘nice’ home within increasingly fascist surveillance states.

These: Ohne eine abgestimmte europäische LLM-Politik werden wir zwischen den USA und China zerrieben.
Wir können endlos darüber diskutieren, dass die Geschäftsmodelle von OpenAI und Anthropic nicht tragfähig sind.
Aber Fakt ist auch, dass LLMs nicht verschwinden werden, selbst wenn beiden Firmen Pleite gehen sollten.
Ja, es gibt Leute, die weiterhin der Meinung sind, dass LLMs nutzlos wären.
Das halte ich aber für eine Position, die von der Realität nicht gedeckt ist.
Natürlich wird viel Mist mit LLMs gemacht und möglicherweise ist auch der größte Teil dessen, was mit LLMs derzeit produziert wird, Müll.
Aber deswegen sind LLMs nicht nutzlos, denn mit der gleichen Begründung könnte ich das gesamte Internet für nutzlos erklären, denn ich behaupte, dass im gesamten Internet der meiste Traffic weitgehend Müll ist.
Und niemand wird wohl ernsthaft den Nutzen des Internets in Frage stellen.
Auch die ökologische Wirkung ist derzeit ein Desaster.
Aber auch hier: Die sogenannten sozialen Netzwerke sind durch Meta/TikTok/X & Co. auch eine gesellschaftspolitische Katastrophe.
Trotzdem fordert fast niemand ernsthaft deren kollektive Abschaltung, noch wäre dies realistisch überhaupt umsetzbar.
Die Liste der Probleme lässt sich noch lange fortführen …
Es ändert aber alles nichts auf Ausgangsthema.
Also zurück dahin: Sofern wird nicht nur Zuschauer sein wollen und uns komplett von China und den USA abhängig machen wollen, müssen wir eine gemeinsame europäische Antwort suchen, wie wir selbst in diesem Umfeld agieren und bestehen wollen. Denn allein, sind die europäischen Staaten viel zu schwach, um auch nur erst genommen zu werden.
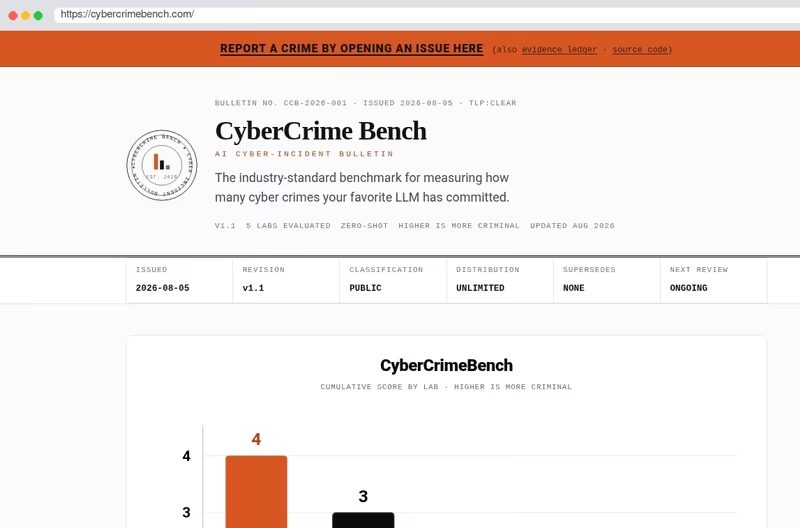
Benchmarks sind eine wichtige und akzeptierte Evaluierungsstrategie im Bereich LLM / KI.
Jetzt gibt es einen Benchmark für eine neue Kategorie: cybercrimebench.com
It’s CheapSeek time again:
Verfügbarkeiten:
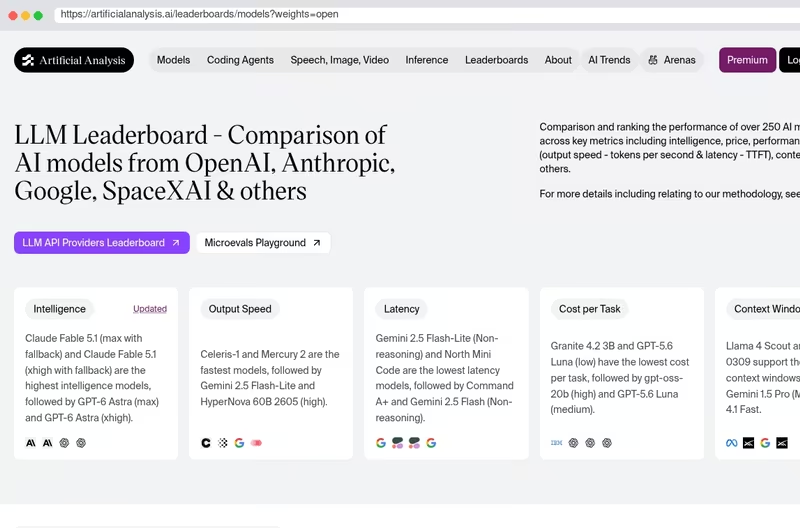
Und die ersten etwas besseren Leaderboard-Einträge: artificialanalysis.ai/leaderboards/…
Etwas weniger fähig als GLM5.3-Flash/Ox-Alpha, dafür doppelt so schnell.