Posts by Julian Pawlowski · 45 posts

All Own posts Reposts Replies

Reposted by Julian Pawlowski

Julian @Loredo chaos.social

Tibber Prices v0.35 and v0.36 bring their own dashboard cards to Home Assistant. They ship with the integration, nothing extra to install.

📅 Forecast: today and tomorrow like a weather forecast
📈 Chart: the price curve, no ApexCharts needed
⏱️ Now: the current price as tile, gauge or clock

Tap a card to open another one in a window.

github.com/jpawlowski/hass.tibber_prices

HomeAssistant Tibber HACS SmartHome HomeAutomation
+2 Less OpenSource EnergyPrices
Home Assistant dashboard card showing electricity prices like a weather forecast: the current price of 2.91 kr/kWh marked "Very Expensive", hourly bars for today and tomorrow colored by price level, and summaries for parts of the day and for both days.
Three variants of the Tibber Prices chart card in Home Assistant: step charts of the electricity price in 15-minute intervals, colored by price level, with the daily low and high marked and tabs for outlook, today, tomorrow and two days.

KI-Nutzung ist einsam

Wer heute mit KI arbeitet, arbeitet allein. Das Gegenüber ist da und antwortet sofort, und trotzdem sieht niemand zu. Niemand sieht, wie die Session gelaufen ist, wo sie hakte, was dreimal gesagt werden musste, bis das Ergebnis stand. Am Ende liegt ein Text, ein Skript, eine Auswertung auf dem Tisch, und das Ergebnis sieht gut aus. Der Weg dorthin ist weg.

Das klingt harmlos, bedeutet aber, dass jede Person den Umgang mit dem Werkzeug für sich allein lernt und dieses Wissen niemanden erreicht.

Das ist eine Beobachtung aus meiner eigenen Arbeit, keine Studie. Ich kann sie nicht beweisen, und ich schreibe sie trotzdem auf, weil ein paar Zahlen, die ich nachgeschlagen habe, in dieselbe Richtung zeigen. Darum geht es hier: warum das so ist, warum es kaum jemandem auffällt, und was dagegen hilft.

Der zweite Platz am Tisch ist besetzt

Beim Programmieren gab es dafür einmal ein Verfahren: Pair Programming. Zwei Personen, eine Tastatur. Eine tippt, die andere denkt mit, fragt nach und sieht den Fehler, bevor er im Code landet. Der Nutzen kam nie vom Tippen, sondern vom Zusehen.

Eine KI-Session sieht auf den ersten Blick genauso aus. Eine Person, ein Gegenüber, das mitdenkt und antwortet. Und das betrifft längst nicht nur Leute, die programmieren: Wer das volle Potenzial will, landet bei den Kommandozeilenwerkzeugen aus der Softwareentwicklung, auch ohne je eine Zeile Code schreiben zu wollen. Texte, Auswertungen, Recherchen, ganze Arbeitsabläufe laufen heute über Werkzeuge, die für Programmierarbeit gebaut wurden.

Nur ist der zweite Platz am Tisch von der KI besetzt. Der Mensch, der zusieht und irgendwann fragt “Warum hast du das jetzt so formuliert?”, fehlt. Die KI stellt diese Frage nicht, sie macht weiter.

Das Gewicht geht hoch, also stimmt die Technik

Wer allein im Fitnessstudio trainiert, merkt lange nicht, wenn die Ausführung falsch ist. Das Gewicht geht hoch, die Zahl auf der Scheibe steigt, alles sieht nach Fortschritt aus. Den Schaden sieht Jahre später erst die Physiotherapie.

Mit der KI ist es dasselbe. Sie liefert immer etwas Plausibles, es gibt keinen Compilerfehler, keine Kollegin, die beim Lesen die Stirn runzelt, keinen Moment, in dem das Werkzeug sagt: So hättest du es schneller haben können. Das Ergebnis ist der einzige Maßstab, und das Ergebnis sieht fast immer gut aus.

Daraus entsteht eine Selbstüberschätzung, die niemand böse meint. Wer mit dem eigenen Ergebnis zufrieden ist, sieht keinen Grund, von anderen zu lernen, und schon gar nicht von deren Fehlern. Die Notwendigkeit verschwindet nicht, sie wird nur unsichtbar.

Das ist nicht nur mein Eindruck. Eine Studie der Aalto University (Fernandes u. a., Computers in Human Behavior, 2026) ließ 246 Teilnehmende mit ChatGPT Aufgaben zum logischen Denken lösen, eine zweite Runde mit 452 Teilnehmenden wiederholte das. Mit KI schnitten alle besser ab, und alle überschätzten ihre Leistung. Am stärksten überschätzten sich die, die am meisten über KI wussten. Die meisten stellten pro Aufgabe genau eine Frage und übernahmen die Antwort.

“Ich tausche mich doch aus”

Stimmt, über KI wird viel geredet: welches Modell gerade besser ist, welcher Prompt funktioniert hat, welche neue Funktion es gibt. Das ist Rezepttausch, und Rezepte sind nützlich. Er läuft heute dort, wo auch sonst alles läuft, in Posts und Likes, und ein Like ist das Gegenteil von Zusehen.

Gemeinsam gekocht wird dabei trotzdem nicht. Kaum jemand sitzt zu zweit vor einer Session. Kaum jemand erzählt, an welcher Stelle das Gespräch mit der KI gekippt ist, wie es zurückgeholt wurde, welche Rückfrage den Unterschied gemacht hat. Genau dieses Wissen ist das Wertvolle, und genau dieses Wissen verblasst oft schon, während die Session noch läuft. Am Ende bleibt das Ergebnis und ein vages “Nächstes Mal mache ich das anders”.

Wie genau, bleibt das Geheimnis der Person. Und so erarbeitet sich im selben Team jede Person dasselbe Wissen noch einmal, Session für Session, allein.

Die Zahlen dazu gibt es. Nach dem Ivanti Technology at Work Report 2025 verschweigt knapp ein Drittel der Beschäftigten, die KI nutzen, das ihrem Arbeitgeber; 36 Prozent davon sagen, sie mögen den geheimen Vorteil. Im AI Paradox Report 2026 von Employment Hero sagt die Hälfte der Beschäftigten, ihr Arbeitgeber tue wenig oder nichts, damit sie KI lernen, und mehr als die Hälfte hat es sich über YouTube, TikTok, Reddit und Discord beigebracht. Wer einen Vorteil geheim hält, teilt ihn nicht. Wer bei YouTube lernt, lernt allein.

Pair Prompting: zu zweit vor eine Session

Die Lösung ist alt und braucht keine neue Software. Sie braucht eine zweite Person. Und sie braucht eine Warnung vorweg.

Microsoft hat bei Gap Inc. mit 388 Beschäftigten getestet, was passiert, wenn Paare ein vorgeschriebenes Protokoll für gemeinsame KI-Nutzung befolgen müssen (Farach u. a.,März 2026). Die Paare mit Protokoll lieferten an diesem Tag schlechtere Dokumente und seltener überhaupt eins. Zur Einordnung: Alle Autoren arbeiten bei Microsoft, das Werkzeug war Copilot, die Studie ist nicht vorregistriert, und benotet hat ein Sprachmodell, das lange Texte mag. Das schreiben die Autoren selbst. Gemessen wurde Output an einem Nachmittag, nicht, was die Paare voneinander gelernt haben. Ich nehme aus der Studie trotzdem eines mit: Verordnete Zusammenarbeit wird zur Koordinationsaufgabe und verdrängt die Arbeit.

Die Gegenprobe gibt es auch, vorregistriert und ohne Einfluss des Unternehmens auf die Ergebnisse: ein Feldexperiment der Harvard Business School mit 791 Fachleuten bei Procter & Gamble (Dell’Acqua u. a., Organization Science, 2026). Einzelpersonen und Zweierteams arbeiteten jeweils mit und ohne KI an echten Produktideen. Eine Person mit KI war so gut wie ein Team ohne. Das klingt zunächst wie ein Argument gegen den zweiten Menschen, und genau deshalb passt es in diesen Text: Der zweite Platz am Tisch ist tatsächlich besetzt. Zweierteams mit KI waren im Schnitt nicht messbar besser als Einzelpersonen mit KI. Unter den besten zehn Prozent der Lösungen aber waren die Teams mit KI deutlich häufiger. Der Unterschied zwischen gut und herausragend kam vom zweiten Menschen.

Deshalb geht es im Folgenden nicht um Vorschrift und nicht um schnellere Ergebnisse. Es geht darum, dass jemand sieht, wie die andere Person arbeitet.

Ein Beispiel, das mir nahe liegt: dieser Text. Er ist mit KI entstanden, und kein Gedanke darin stammt von ihr. Die Inhalte sind meine, die KI hilft beim Formulieren, mal mehr, mal weniger, je nachdem, wie gut ich an dem Tag selbst schreibe. Dass das funktioniert, liegt an Vorarbeit, die im Text unsichtbar bleibt: ein Profil, in dem steht, wie ich schreibe und was ich nicht lesen will, dazu eine Reihe weiterer Anleitungen für wiederkehrende Aufgaben. Das hat mich Wochen gekostet, und ich bin bis heute nicht sicher, ob ich es richtig gemacht habe, weil es niemand gesehen hat.

Die meisten überlassen diese Anpassung dem Werkzeug. Die KI schreibt sich selbst Notizen über das, was zufällig in einem Gespräch vorkam, und hält das für ein Profil. Das ist kein Fehler des Werkzeugs, es weiß nicht, was fehlt. Nur: Woher soll jemand wissen, dass hinter einem guten KI-Text Wochen Vorarbeit stecken, wenn die Wörter ohne diese Vorarbeit auch schon flüssig kommen? Und wer zeigt dieser Person, wie sie anfängt? Die KI selbst kann das nur bedingt. Sie kann sagen, was technisch geht. Sie sieht nicht, was bei mir über Monate funktioniert hat und was still gescheitert ist, weil sie jede Sitzung bei null anfängt. Diesen Vergleich hat nur, wer mir über die Schulter geschaut hat. Bisher niemand.

Drei Dinge, die das ermöglichen:

  • Zu zweit an einer Session arbeiten: Eine halbe Stunde, ein Bildschirm, eine Person tippt, die andere sieht zu und fragt nach: Warum jetzt diese Rückfrage? Warum hast du den Vorschlag verworfen? Woran hast du gemerkt, dass die KI vom Thema abkommt? Die Fragen sind das Training, für beide.
  • Verläufe teilen statt Ergebnisse: Das fertige Dokument zeigt nicht, wie es entstanden ist. Der Chatverlauf zeigt es. Wer einen Verlauf mit einer Kollegin durchgeht, lernt in zehn Minuten mehr über deren Arbeitsweise als aus zehn fertigen Dokumenten.
  • Stolpersteine aufschreiben, solange sie frisch sind: Nach der Session drei Zeilen: Was musste ich der KI dreimal sagen? Wo hat sie mich falsch verstanden? Was würde ich beim nächsten Mal zuerst sagen? Sichtbar für das Team, nicht in der eigenen Notiz-App.

Das alte Gegenargument gilt nicht mehr

Pair Programming hat sich nie flächendeckend durchgesetzt, und der Grund war immer derselbe: Es fühlte sich teuer an. Zwei Leute für die Arbeit von einer. Bei Microsoft hatten 2008 22 Prozent der Befragten je zu zweit programmiert; im laufenden Projekt taten es 3,5 Prozent.

Bei der KI trägt das Argument nicht mehr. Die Arbeit macht das Werkzeug. Die zweite Person kostet nur noch die halbe Stunde, in der sie zusieht. Was diese halbe Stunde einspart, sieht heute niemand, weil niemand weiß, was die andere Person längst gelernt hat.

Google macht den Kachelmann: Echtzeit-Wetterdaten eröffnen neue Werbemöglichkeiten

tagworx.net/ynews.php?cid=1&nid=39066

1

Damit die Oligarchen besser im Griff haben, was den Leuten über die Klimakatastrophe (nicht) erzählt wird. So vorhersehbar.

Reposted by Julian Pawlowski

Julian @Loredo chaos.social

Also working on having my own #HomeAssistant theme based on my personal home brand, in the design of Apple’s #LiquidGlass design language.

This is actually not really easy to do even with Claude. Takes a lot of iterations for him to investigate the DOM, still ongoing…

Game changers here:

HomeLab HomeBrand

Reposted by Julian Pawlowski

Julian @Loredo chaos.social

Even the Proxmox servers got their little brand!

How I did all of that? Starting to use @wintermeyer’s #Heinzel was a real boost in speed because doing all of this by hand would have been extremely time consuming!

I even gave Heinzel its own LXC with read-only access everywhere (either SSH, API’s, whatever was possible) to always help diagnose from everywhere.

github.com/wintermeyer/heinzel

Replying to @jpawlowski

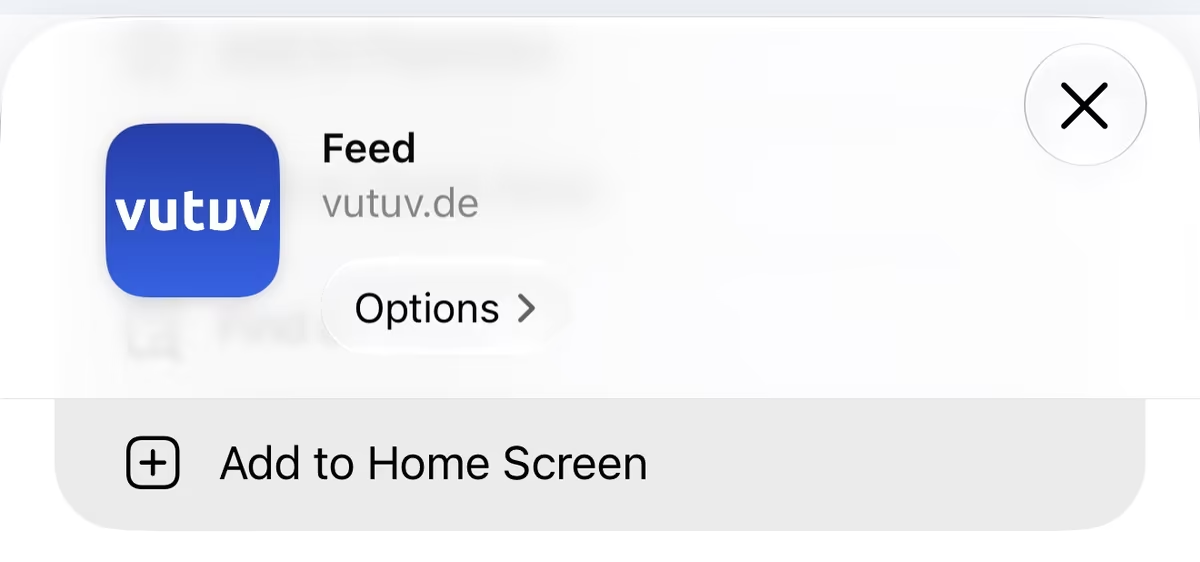
Jetzt hat der Boomer es auch mal auf dem iOS Homebildschirm installiert. WOW! Toll!

Danke @jpawlowski! Sehr praktisch.

1

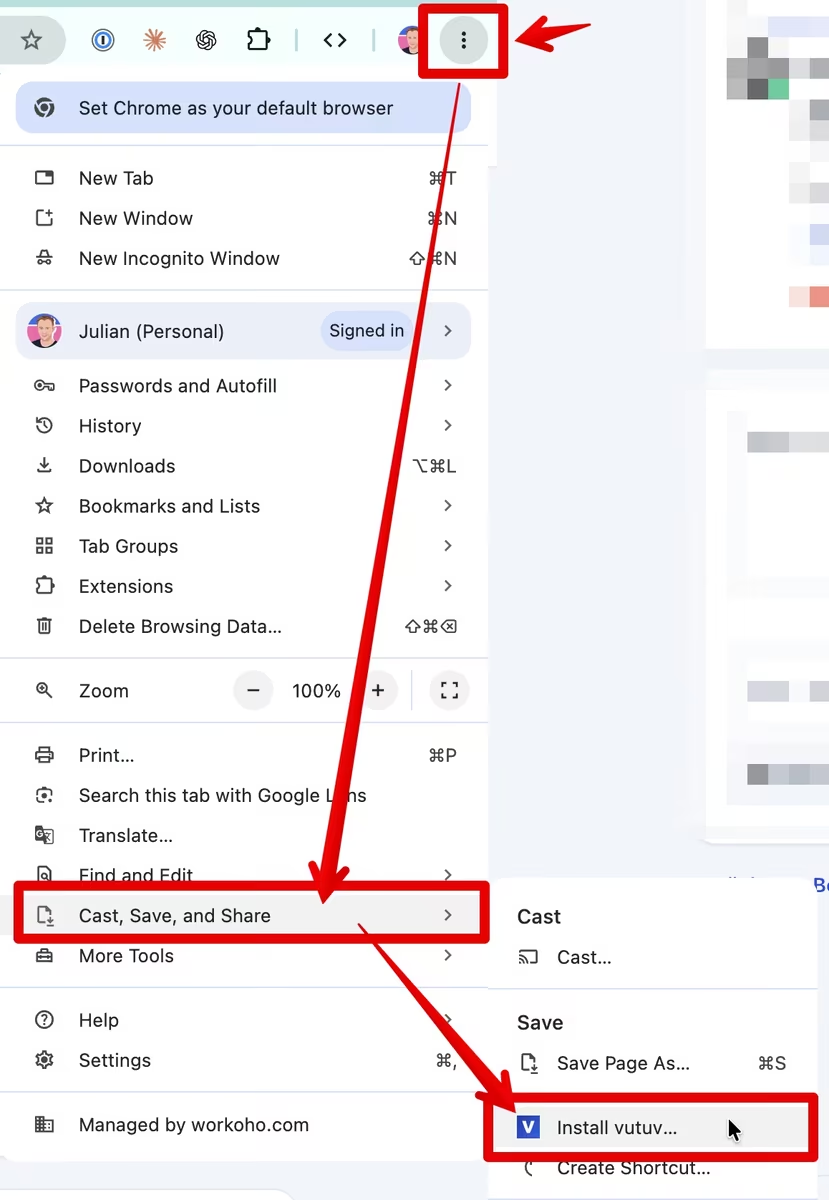
Geht auch mit Browsern am Desktop, zum Beispiel in Chrome:

Ich glaube @jpawlowski hat beim Thema Progressive Web App (PWA) bei der vutuv Webseite gezaubert. Für mich Boomer ist das ja alles nur modernes Zeugs. 😉 Schaut es Euch mal an.

@jpawlowski Vielleicht kannst Du was dazu schreiben und auch einen Screenshot hinzufügen.

2

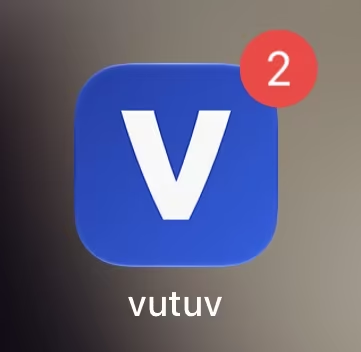
Ja auf dem Startbildschirm ablegen geht.

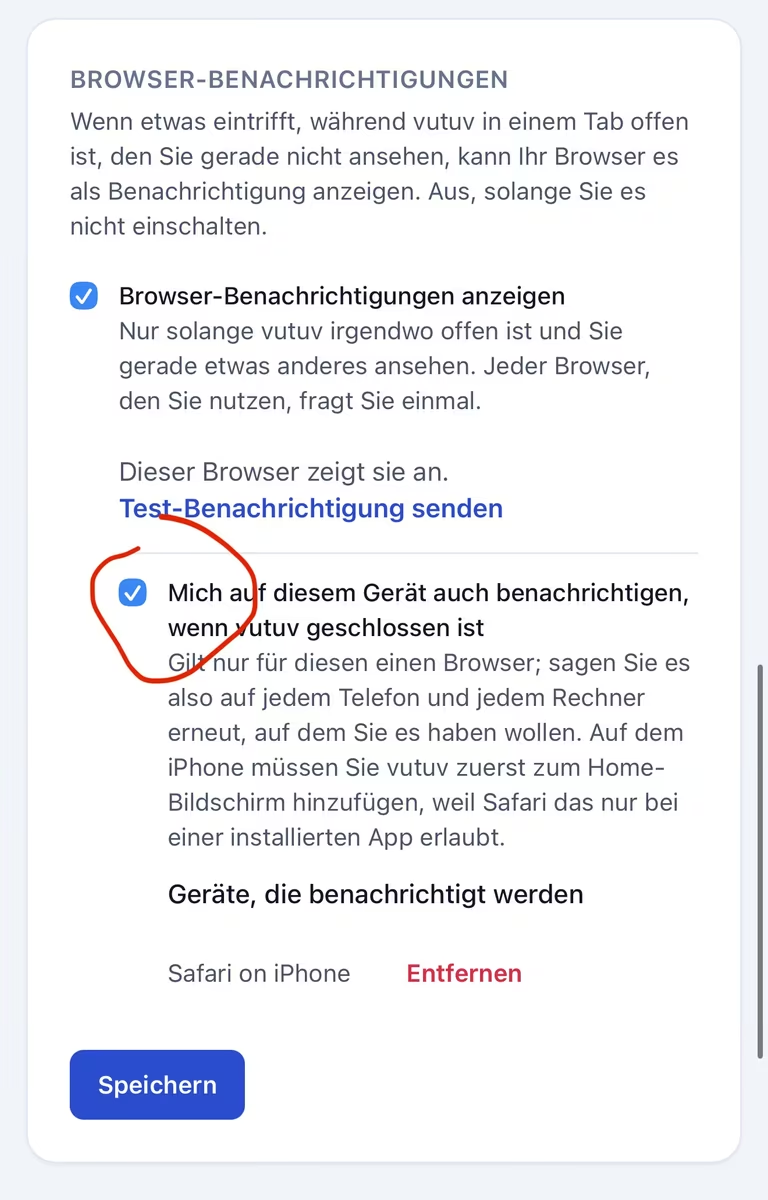
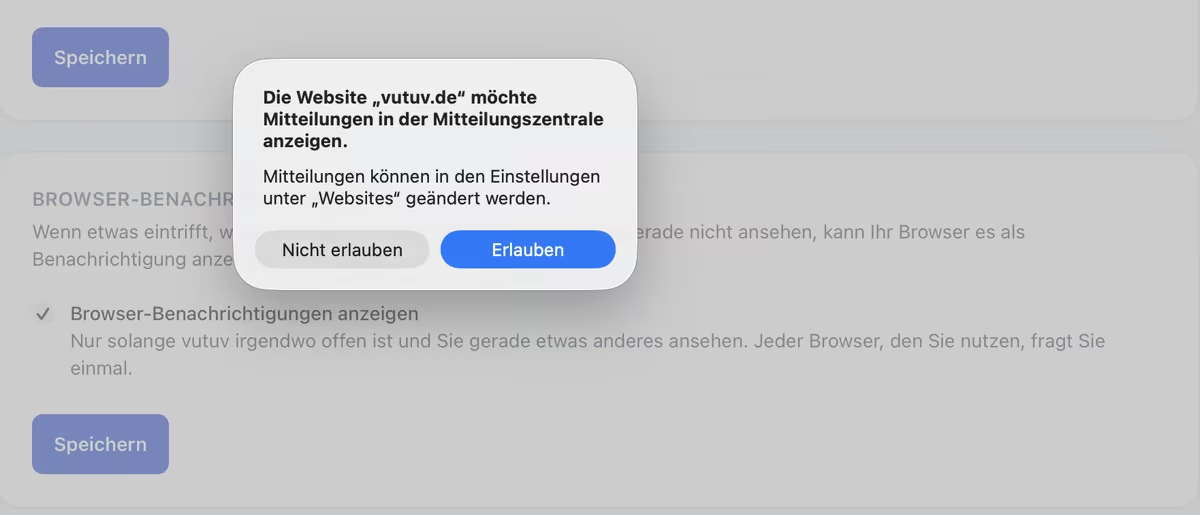
Benachrichtigungen kann man je Endgerät dann entsprechend einschalten und bekommt dann auch den von normalen Apps gewohnten Message Counter.

1

Replying to @reneoelke

Bleiben die Filter erhalten? Oder könnte man sie als Button ablegen (in der Reihe mit dem Button für neue Nachrichten)?

Man wird die Filter sortieren und auch einklappen können.

Ich fand die 1-Klick-Filter für Fediverse und vutuv ganz nützlich.

Ich am Anfang auch. Dann ging mir aber das ewige hin- und her-klicken auf den Nerv. Idealerweise ist das neue super für Power-User und stört wenig User nicht. Schmaler Grad.

Die vutuv Nachrichten gingen bei den vielen Mastodon-Infos zu sehr unter.

Mal überlegen, ob man das irgendwie in den Griff bekommen kann.

1

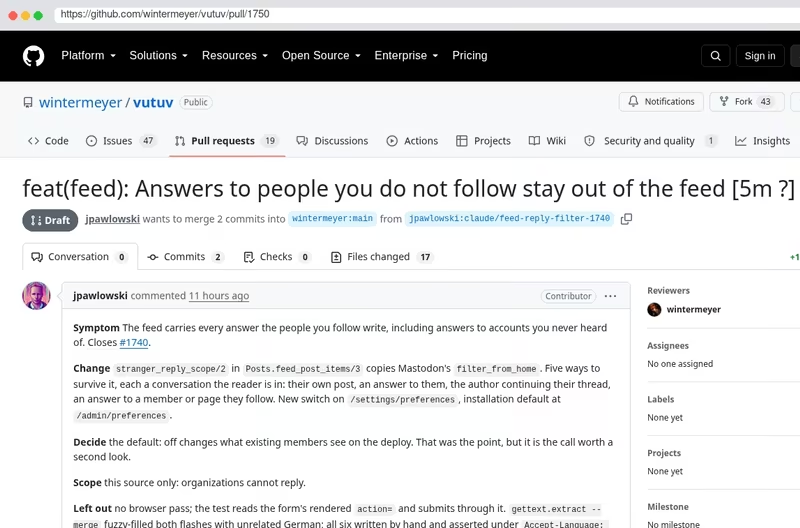
Was den Feed betrifft, so würde das hier glaube ich schon eine enorm bessere Übersicht schaffen:
Answers to people you do not follow stay out of the feed

Replying to @jpawlowski

Wenn Du Zeit für ein solches Issue hast, würde ich mich freuen. Ich mache das gerne, bin aber kein PWA Spezialist.

1

Hab die Issue Liste mal angelegt und der Gerät™ arbeitet an einigen von denen schon.

1

Replying to @wintermeyer

Sehr wichtig meiner Meinung nach, da LinkedIn heutzutage gefühlt nur noch aus Spam besteht. Find den Ansatz auch sehr interessant, bin aufs nächste Update dazu gespannt!

Ach und zum Begriff hätte Ich einen Vorschlag: Da diese getarnten Werbungen ja eigntlich per definition Schleichwerbung entsprechen, fände Ich es auch angebracht diese Posts dann visuell als “Werbung” (DE) bzw “Advertisement” (EN) zu markieren. Idealerweise auf erstem Blick direkt sichtbar damit der Post mental eingeordnet werden kann.

(“Schleichwerbung” direkt wäre auch cool, aber da wird i18n schwierig 😅)

2

welcher Post, der von einem Org-Account kommt, würde denn für dich nicht unter diese Einordnung fallen?

Ich werde heute die Anzeigelogik im normalen vutuv Feed verbessern. Aktuell sind da hin und wieder Logikfehler drin, wenn jemand aus dem Fediverse mit einem vutuv Post interagiert. Das ist überraschend komplex in der Programmierung. Deshalb wie immer: Keine Panik, wenn etwas nicht direkt 100% funktioniert! Wir sind nicht im OP. Es muss keiner bei Fehlern sterben. Bitte mir eine Nachricht schicken oder am besten direkt ein Issue im GitHub aufmachen.

Und natürlich interessiert es mich, ob Ihr die Veränderung gut oder schlecht findet.

1

also the fehlenden Parents wären da schon eine echte Hilfe (sie PR #1623 😘)

1

Replying to @wintermeyer

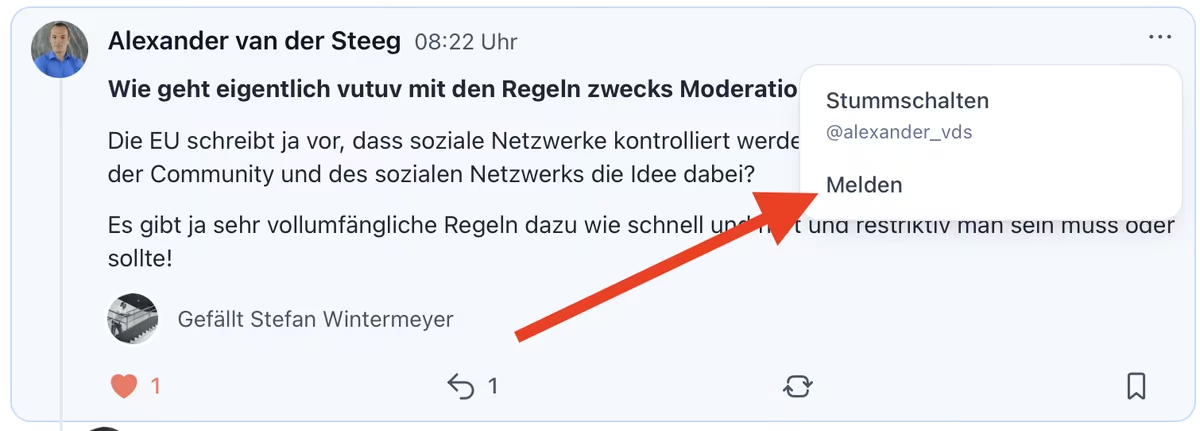
Hier kann man einen Post melden.

1
From other networks 1

1 like

@plinubius@chaos.social liked this

Already counted in the numbers above.

Dass ein Beitrag (oder zumindest wieviele meiner eigenen (oder die der Firma) Beiträge) gemeldet wurde, sollte man eigentlich auch selbst einsehen können in einer zentralen Statistik. Vielleicht nicht alle Gründe, aber ganz sicher, wenn jemand meinen Beitrag als “SPAM” meldet. Ich kann mein Posting-Verhalten ja nur ändern und anpassen, wenn mir diese Informationen auch vorliegen. Ansonsten gehe ich davon aus, dass es schon passen wird. Wenn wir da mehr Transparenz schaffen und die Daten, die für solche Meldungen eh schon erhoben werden, in aufbereiteter Form auch den Verfassern bereitstellen, wäre das ein großer Fortschritt. Auch hier: Ganz ohne KI, low-hanging fruit.

1

Replying to @jpawlowski

Gänzlich alles, was ein Unternehmen über sich und seine Produkte und Dienstleistungen zu erklären hat, oder Webinars oder was auch immer angeboten wird, als SPAM zu bezeichnen ist auf einem Business Netzwerk falsch.

Was wäre den ein gutes Wording dafür? Vielleicht können wir es ja wirklich mal mit der Freiwilligkeit ausprobieren und den Poster die Möglichkeit geben, seinen Post selbst entsprechend zu kategorisieren.

Also Sachen die nicht gerade ganz klassisches Spam sind, aber halt schon irgendwie in die Richtung Werbung gehen?

1

Also was mir da spontan einfällt ist vor allem: Die Wegnahme des “Daumen runter” Buttons aus allen sozialen Netzwerken war damals ein großer Rückschritt, weil es keine Gegengewichte mehr gibt. Der Grund, dass man damit Ragebait verhindern will, war (finde ich) vorgeschoben, da man im Ergebnis in den Kommentaren das Problem ja weiterhin hat.

Will sagen: Es fehlt hier eine Möglichkeit des fairen Feedback, wenn mir etwas nicht gefällt. Zumindest auf YouTube gibt es ja zumindest die Möglichkeit, dass man einen Daumen nach unten gibt, aber wieviel und von wem das gegeben wurde, das sieht dann nur der Seiten-Owner. So würde ich es hier mit Firmenaccounts auch machen: Jeder, dem etwas nicht gefällt, kann das auch ohne einen Kommentar zu schreiben und eine Diskussion anzufangen ganz leicht der Firma mitteilen, indem er den Daumen runter gibt. Die Firma sieht wieviele und ehrlich gesagt sollte sie auch sehen können, wer den Daumen runter gegeben hat. Die Logik dahinter wäre, dass keine Firma Geld und Ressourcen dafür verschwenden wird für Inhalte, die schlecht ankommen.

Wenn ich dem Firmenaccount nicht folgen will, kann ich ja auch den einzelnen Mitarbeitern folgen. Davon ausgehend, dass dort weniger/kein “SPAM” gepostet wird. Ob man da auch ein Downvote braucht oder konsequenterweise auch da einführt, weiß ich nicht…

Man kommt dabei ohne einen speziellen Flag “SPAM” aus, ganz einfach aus dem Grund, weil ein Firmenaccount alleine impliziert schon, dass ich da natürlich sowas bekomme! Wie du sagst, wenn ich das nicht will, folge ich der Firma nicht. Vielleicht kann ich aber stattdessen, wenn ich die Firma aber grundsätzlich toll finde, ihr ein Herzchen an sich geben statt ein Follow.

Bei alldem ist übrigens dann noch kein Stück “KI” mit drin! Wir generieren nur Zusatzinformationen, die für die Firma sehr wertvoll sind. Und wer sich traut, kann ja sogar bei den Negativ-Votern nachfragen, falls man wirklich nicht selbst drauf kommt, woran es nun liegt… (im Prinzip kann ja auch nur das Thema nicht gefallen, aber muss ja auch nicht jedem gefallen; ich denke sowas merkt man schon anhand der Anzahl und auch im Vergleich mit anderen Posts).

Fediverse kann leider keinen Downvote, aber das heißt ja nicht, dass man es hier nicht anbieten könnte.

LinkedIn und vutuv haben beide mit dem Problem zu kämpfen, dass Posts oft als Beschreibungen, Whitepapers oder allgemeine Informationen getarnt sind, in Wirklichkeit aber Werbung für Produkte oder Dienstleistungen (z.B. Trainings) sind.  Obwohl dies nicht grundsätzlich verwerflich ist, kann es schnell lästig werden.

Ich werde solche Posts nicht verbieten, da es völlig in Ordnung ist, eigene Produkte oder Dienstleistungen zu bewerben oder zu beschreiben. Ich möchte jedoch die Möglichkeit schaffen, diese automatisch zu erkennen und auf Wunsch aus dem Feed zu filtern. Gestern habe ich mit @oliverandrich, einem erfahrenen Prompting-Experten, darüber gesprochen. Er hat angeboten, sich mal Gedanken dazu zu machen. Dieser Prompt würde jedes neue Posting analysieren und im Falle einer Übereinstimmung als SPAM markieren. In den Einstellungen würde es dann eine Option geben, Posts, die als SPAM markiert wurden, aus dem Feed auszublenden.

Der Begriff SPAM ist zwar nicht ganz passend, aber mir fällt derzeit keine bessere Alternative ein.

7
From other networks 2

1 like 1 reply

@plinubius@chaos.social liked this

Already counted in the numbers above.

Die Frage ist ja, was man sich von einem Business Netzwerk erwartet?

Gänzlich alles, was ein Unternehmen über sich und seine Produkte und Dienstleistungen zu erklären hat, oder Webinars oder was auch immer angeboten wird, als SPAM zu bezeichnen ist auf einem Business Netzwerk falsch.

Das Problem bei LinkedIn ist, dass die Inhalte und die Frequenz nicht mehr für die Menschen gemacht sind, sondern nur noch für den Algorithmus.

Für Firmen und Personen, die hier her kommen, muss eigentlich klar gemacht werden, dass sie hier bereit sein müssen, ihren Habitus hier nochmal auf 0 zu setzen und es nicht parallel mit LinkedIn einfach mit den gleichen Inhalten zu besudeln. Damit wäre schon viel gewonnen!

2

Replying to @johannes_tigges

Für so einen neumodischen Kram bin ich zu alt. 😂

Habe ich mich noch nicht mit befasst. @jpawlowski Du?

1

Ja, hab dazu schon ein Issue aufmachen wollen. An der PWA Experience kann man sicherlich noch einige Kleinigkeiten (wie Push Notifications) hinzufügen, so dass man eine ähnliche Experience hat wie mit einer Native App.

2

Ich persönlich bin kein großer Fan von Browser-Benachrichtigungen. Allerdings hat mich @jpawlowski davon überzeugt, dass sie für viele Nutzer tatsächlich praktisch sein können.  Die Funktion kann jetzt unter vutuv.de/settings/notifications aktiviert werden. Standardmäßig ist sie deaktiviert.

2

🤷‍♂️

1

Reposted by Julian Pawlowski

Julian @Loredo chaos.social

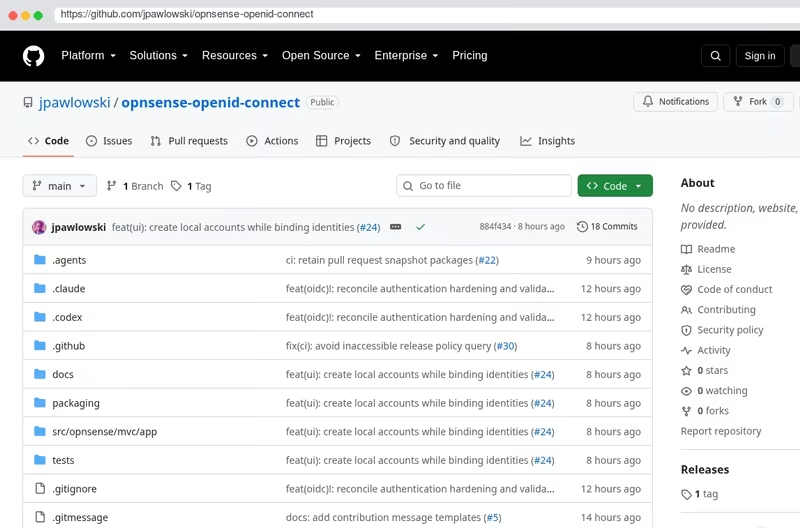
Last weekend I felt like starting to implement a full OpenID Connect plugin for #OPNsense so the integration to my #Authentik instance becomes more natural, reliable, and secure.

The first beta looks very promising to me and is already feature complete I shall say. Bugs, of course, are included but anyway, it supports over 20 IdP’s out of the box, including all major social media sign-in providers so running your own IdP becomes optional! 🎉

github.com/jpawlowski/opnsense-openid-c…

Warum ich Mentorin bin? – Weil Erfahrung wertvoller wird, wenn wir sie weitergeben.

20 Jahre Projektmanagement.
Internationale Konzerne.
Interdisziplinäre und interkulturelle Teams.
Und ziemlich oft: eine der wenigen Frauen im Raum.

Auf diesem Weg habe ich viel mitgenommen und Erfahrung gesammelt: über Multimillionen-Projekte und Führung, aber auch über die unausgesprochenen Spielregeln in männerdominierten Unternehmen, über Sichtbarkeit, Selbstzweifel, schwierige Entscheidungen und darüber, mutig zu sein und den eigenen Weg zu finden.

Nicht alles davon muss jede Frau selbst mühsam lernen. Deshalb freue ich mich sehr, dass ich ab sofort auch Teil der MentorMe-Community bin.

Mentoring bedeutet für mich

✨ Erfahrungen zu teilen,
✨ ehrlich zu sein, auch über Umwege und Fehler,
✨ die richtigen Fragen zu stellen,
✨ neue Perspektiven zu öffnen und manchmal auch
✨ den kleinen Schubs zu geben, den es braucht, um sich selbst mehr zuzutrauen.

Besonders freue ich mich auf den Austausch mit Frauen aus dem Projektmanagement, die sich weiterentwickeln, mehr Verantwortung übernehmen oder vielleicht den nächsten Schritt in Richtung Führung gehen möchten.

Ich weiß noch sehr genau, was es bedeutet, wenn eine jüngere Kollegin vor dir steht und sagt: „Ich möchte mal so sein wie du.“

Heute würde ich ihr antworten:
„Werde nicht wie ich. Werde die Version von dir, die du vielleicht heute selbst noch nicht sehen kannst.“

Und wenn ich auf diesem Weg ein Stück begleiten kann, dann tue ich das sehr gerne. ❤️

Wenn du Teil der MentorMe-Community werden möchtest und einen Mentor oder eine Mentorin suchst, kannst du dich hier anmelden: [mentorme-ngo.org/mentee_werden/…](https://mentorme-ngo.org/mentee_werden/)

imyourmentor mentoring womenempowerment femaleleadership

Replying to @jpawlowski

Letzten Endes sind viele Systemdesign, Dekomposition von Aufgaben, Hardwarelimits usw Fragen auch so noch relevant ohne direkt in den Code gesehen zu haben.

Ich vermute hier eine Form von Repräsentation höherer Stufe. Ganz dem Assembler -> Hochsprachen Übergang.

Und in zweiter Form würde ich vermuten, dass es ganz klassisch, ähnlich den Tischlern, eine Ausbildung an Teilen der manuellen Form und dann an den “Power tools” geben dürfte. Und ggf. Spezialisierungen die sich auf das Wühlen im Originalcode richten.

Oder vielleicht auch direkt ausführbare higer level Repräsentationen?

1

Die Frage ist, ob man die richtigen Fragen stellen kann und die Antworten versteht. Oder ob man überhaupt auf eine Frage kommt, ohne die Struktur vom Quellcode gesehen zu haben.

Sicherlich wird sich da noch viel zusammenrütteln in den nächsten Monaten und Jahren. Aber ich glaube nicht, dass es ansatzweise irgendwelche Vergleiche zu früheren Änderungen gibt.

Das ganze “digitale Souveranität” Thema wird immer gerne rumgereicht. Und für KI wirds ebenso so wichtig, wenn nicht wichtiger. Leider ist Deutschland hier auch wieder kurz vor abgehängt. Aber…

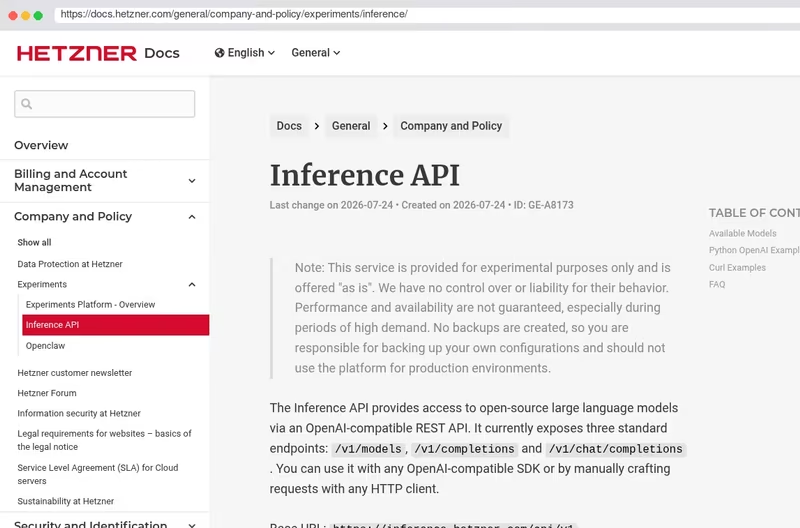
@hetzner@mastodon.hetzner.social to the rescue. Da scheint gerade die Aufbau-Phase fürs Inference-Only Hosting mit OpenWeight-Modellen zu laufen. Aktuell Qwen 3.6 und das aktuelle Qwen 3.8.

Und in dem Zusammenhang gibt’s aktuell eine kostenlose Testphase mit Free-Tokens: docs.hetzner.com/general/…

Qwen 3.8 scheint unter der Last zusammengebrochen zu sein, 3.6 reagiert.

OpenCode hat es schon als direkt verwendbaren Provider integriert.

Fragt sich ob das mit ZDR (Zero Data Retention) läuft und wie die zukünftigen Pläne für Flatrates, ZDR, andere Modelle wie DeepSeek V4 Flash und dergleichen aussehen. Sie sind an Feedback interessiert, sagt die Website.

hetzner LLM inference openweightmodels freebeer
1
From other networks 1

1 like

@lenzgr@mastodon.social liked this

Already counted in the numbers above.

Replying to @jpawlowski

Den Beobachtungen kann ich nur zustimmen.

Ich kann an der Stelle immer auch gerne OpenCode empfehlen, insbesondere auch für die Fähigkeiten dort beliebige Modelle anklemmen zu können. Und sich das ganze bei Bedarf komfortabel zurecht hacken zu können.

Ansonsten natürlich eine der Ticket Lagerstätten für sauber aufgetrennten externen und wieder aufnehmbaren Kontext quer über Harnesses.

Letztlich ein weiteres Beispiel von “saubere SWE Praktiken mit menschlichen SWE übersetzen sich idR auch zu guten Resultaten mit maschinenbasierten SWEs”.

1

@johannes_tigges In das Rabbit Hole OpenCode wollte ich bisher noch nicht reinfallen ehrlich gesagt, aber irgendwann wird das kommen 😉

1

Wie ich aktuell mit mehreren Coding-Agenten arbeite

Inzwischen merke ich immer deutlicher: Es gibt nicht den einen perfekten Agenten – und vermutlich auch nicht die eine perfekte Entwicklungsumgebung – für alles.

Ich arbeite aktuell vor allem mit Claude und Codex und merke dabei, dass beide unterschiedliche Stärken haben.

Claude gefällt mir häufig bei Planung, Struktur und einer ersten Umsetzung innerhalb vorhandener Projektregeln. Codex empfinde ich oft als pragmatischer und direkter und setze ihn deshalb gerne als zweiten Blick oder für Reviews ein.

Dabei ist das aber längst kein fester Workflow mehr.

Je nach Aufgabe wechsle ich zwischen den Werkzeugen und lasse auch bewusst einen Agenten auf die Arbeit des anderen schauen.

Der eigentliche Schlüssel ist gemeinsamer Kontext

Damit das funktioniert, muss das Repository selbst gut vorbereitet sein.

Guidelines, Skills, Projektregeln, Tests und eine verständliche Entwicklungsumgebung werden für mich immer wichtiger.

Denn wenn jeder Agent erst wieder neu erraten muss, wie ein Projekt aufgebaut ist und welche Regeln gelten, verliert man einen großen Teil des Produktivitätsgewinns.

Mein Ziel ist deshalb weniger, den „besten“ Agenten zu finden.

Ich möchte ein Projekt so vorbereiten, dass unterschiedliche Agenten sinnvoll daran arbeiten können und austauschbar bleiben.

Agentische Entwicklung findet für mich nicht nur in Agent-First-IDEs statt

Ich nutze VS Code mit Devcontainern ebenfalls intensiv für agentische Entwicklung.

Der Unterschied ist für mich eher: Dort kann ich den Agenten wesentlich besser auf die Finger schauen.

Ich sehe Dateien, Diffs und die Struktur des Projekts direkt vor mir, kann Änderungen gezielt nachvollziehen und habe stärker das Gefühl, jederzeit eingreifen zu können.

Agent-First-Umgebungen wie Claude Code oder Codex sind dagegen besonders angenehm, wenn ich eine Aufgabe stärker delegieren und den Agenten relativ selbstständig daran arbeiten lassen möchte.

Für mich läuft es deshalb nicht auf VS Code oder Agent hinaus.

Und auch nicht auf Claude oder Codex.

Sondern auf eine Kombination daraus – abhängig davon, was ich gerade erreichen möchte und wie eng ich die Umsetzung begleiten will.

Vielleicht ist genau das die neue Fähigkeit:

Nicht nur Code zu schreiben, sondern für jede Aufgabe den richtigen Agenten, den richtigen Kontext und die passende Arbeitsumgebung zusammenzubringen.

1
From other networks 2

Bei aller Begeisterung für Agentic Coding bleibt für mich eine Frage offen:

Was bedeutet das eigentlich für die nächste Generation von Entwicklerinnen und Entwicklern?

Ich habe darauf keine einfache Antwort.

Denn bei mir selbst merke ich sehr deutlich: Der Grund, warum ich Agenten heute sinnvoll einsetzen kann, ist mein technischer Hintergrund.

Ich verstehe Konzepte, Architekturen und Abhängigkeiten und kann zumindest beurteilen, ob ein eingeschlagener Weg plausibel ist.

Aber was passiert ohne dieses Fundament?

Ich kann mir nur schwer vorstellen, wie es wäre, mit Agentic Coding aufzuwachsen, ohne vorher selbst Code geschrieben, gelesen, debuggt und Systeme von Grund auf verstanden zu haben.

Genau hier sehe ich eine echte Herausforderung.

Ich glaube nicht, dass die Zukunft darin liegt, jede Zeile Code weiterhin von Hand schreiben zu müssen.

Aber wir dürfen auch nicht den Fehler machen, Verständnis durch reine Bedienung zu ersetzen.

Wer Software nur noch über Agenten erzeugt, ohne die Grundlagen zu verstehen, kann irgendwann kaum noch beurteilen, ob das Ergebnis wirklich gut, sicher oder überhaupt sinnvoll ist.

Und daraus entsteht eine weitere Abhängigkeit: von den Modellen, Werkzeugen und Plattformen, die diese Arbeit für uns übernehmen.

Deshalb bleiben offene Technologien und Wissen wichtig

Das betrifft nicht nur einzelne Entwickler, sondern langfristig unsere gesamte digitale Infrastruktur.

Gerade deshalb halte ich offene Standards, Open Source und Wissenstransfer für wichtiger denn je.

Wir müssen die neuen Werkzeuge nicht ablehnen.

Wir müssen lernen, sie richtig einzusetzen – und gleichzeitig dafür sorgen, dass Menschen weiterhin verstehen, was sie damit erschaffen.

Vielleicht ist genau das eine der großen Aufgaben beim Agentic Coding:

Nicht zu verhindern, dass Maschinen uns Arbeit abnehmen.

Sondern sicherzustellen, dass wir trotzdem noch wissen, was sie da eigentlich für uns tun.

Keyboard shortcuts

Navigation

Home g h
Feed g f
Messages g m
Notifications g n
Your profile g p
Search /

Actions

Write a new post n
Send the post or message you are writing ⌘/Ctrl ↵
Next post in the feed j
Previous post in the feed k

General

Show this help ?
Close menus and dialogs Esc

The single-key shortcuts pause while you type, and are off on phones and tablets.